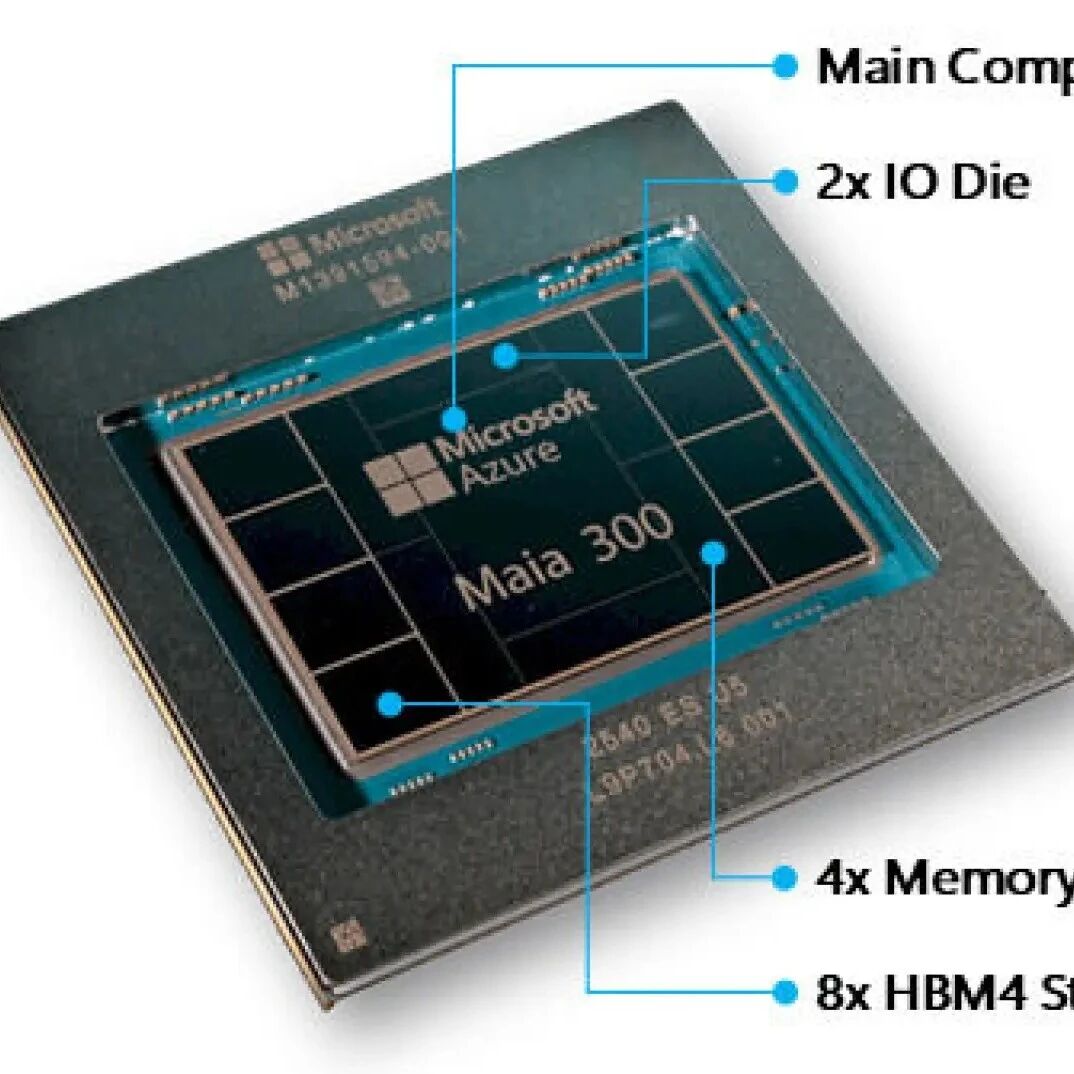
Maia 300芯片

搜索文档
微软打造了一颗怪兽级别的芯片
半导体行业观察· 2026-10-14 09:05
文章核心观点 - 微软面临全球最大的AI推理问题,即使使用最先进的GPU和XPU加速器,生成代币的成本仍然过高 [1] - 微软正全力推进Maia系列定制自主研发XPU加速器,旨在使GenAI推理运行更快且能进一步扩展,以处理更大代理工作负载 [1] - Maia 300芯片进行了许多架构改进,可处理由数十到数百个模型组成的代理工作负载,这些模型通过专家基础模型混合或物理上不同的独立模型混合协同工作,需共享相同网络和内存空间以实现高效低延迟 [1] - 微软在芯片设计方面实力不俗,通常只需两三次尝试就能取得成功 [2] - 多代Azure Maia项目已成为微软人工智能基础设施战略的基石 [3] - Clea Maia 300芯片在所有规格方面突破极限,重点在于有效处理实际GenAI推理工作负载,而非仅追求速度和规格参数优越性 [6] - 微软最引以为豪的指标是在每瓦性能提升2.5倍的情况下,性能提升了7倍 [27] Maia系列芯片发展历程 - 微软于2023年11月推出名为Athena的Maia 100 XPU,试水芯片设计领域,同时发布定制Arm服务器CPU Cobalt 100,但对两款定制芯片架构鲜有提及 [2] - 第二代Braga Maia 200于2026年1月发布,是一款功能更强大的XPU,2026年在Azure云上逐步投入生产 [2] - Maia 200芯片正在为Copilot提供推理支持,帮助微软人工智能团队开发新模型 [3] - GitHub Copilot和Microsoft Foundry将在年底前迁移到Maia 200芯片,GitHub Copilot此前由Maia 100芯片支持 [3] - Maia 200芯片将运行OpenAI的各种模型、微软自研模型以及通过Microsoft Foundry运行的各种开源模型 [3] - 目前尚不清楚OpenAI的GPT API服务有多少是在Maia 100或Maia 200芯片上运行的 [3] - Clea Maia 300于2026年10月宣布,预计2027年某个时候首次部署 [14] Maia 300芯片架构与规格 - Clea Maia 300实际上是一个插槽式芯片复合体,由七个芯片和八个HBM内存堆栈集成在一个中介层上 [6] - Maia 300插槽式系统和构成pod及superpod集群的机器机架具有计算、内存和网络层次结构,可将这些能力聚合应用于GenAI工作 [6] - Clea XPU采用台积电2纳米N2P工艺,并采用芯片组架构,将I/O和HBM控制器与计算和SRAM缓存单元分离 [9] - Maia 300拥有四个tile集群,每个片上集群包含十二个tile,新增了重塑器和tile同步器两个组件 [9] - 重塑器和tile同步器有助于处理贯穿整个系统的数据流,从网络到服务器节点直至最终的tile [9] - Clea芯片封装中心的计算单元上大约有400MB的SRAM缓存,另外200MB嵌入在I/O芯片中,用于缓存进入封装的网络数据和离开封装的计算数据 [10] - Clea封装上的两个I/O芯片中大约有200MB的SRAM [10] - 整个Clea芯片组的总SRAM带宽约为166.2 TB/秒,与八个HBM4堆栈的18 TB/秒HBM内存带宽基本持平 [10] - Clea XPU拥有288 GB的HBM 4内存,据推测与Braga XPU一样均来自SK海力士 [10] - Clea封装的面积约为1980平方毫米,是Braga封装面积810平方毫米的2.4倍 [11] - 晶体管数量约为2800亿,上下浮动可能在10%左右,不包括HBM4内存 [11] - Clea中使用的HBM内存控制器和I/O芯片采用5纳米工艺,而非2纳米工艺 [11] Maia 300与前代产品对比 - Braga芯片拥有更大的HBM内存容量和带宽,同时减少了片上SRAM缓存 [4] - Braga采用大幅改进的AI传输层定制RoCE以太网实现,带宽提升2.3倍,将Maia集群的集群一致性域扩展2.7倍达到6144个设备,功耗仅增加1.5倍 [4] - Braga通过将数据格式从6位MX6升级到4位MXFP4,并将计算核心数量增加1.5倍,同时提升时钟频率,浮点运算性能比Athena芯片提升3.4倍 [4] - Braga XPU的张量单元矩阵比Athena单元大两倍,所需内核数量比预想少一半 [9] - Braga XPU每个片上集群包含10个tile,共有4个集群,总计40个内核,运行频率为2 GHz,每个集群仅激活9个内核以确保台积电3纳米N3P工艺良率 [9] - Athena和Braga芯片均为单片设计,接近光刻机掩模版尺寸极限 [9] - Maia 300的FP4性能为13.80 Petaflops,相比Maia 200的10.15 Petaflops提升1.36倍 [14] - Maia 300的FP8性能为6.90 Petaflops,相比Maia 200的5.07 Petaflops提升1.36倍 [14] - Maia 300的BF16性能为1.73 Petaflops,相比Maia 200的1.27 Petaflops提升1.36倍 [14] - Maia 300的HBM内存带宽为18 TB/秒,相比Maia 200的7 TB/秒提升2.57倍 [14] - Maia 300的HBM内存容量为288 GB,相比Maia 200的216 GB提升1.33倍 [14] - Maia 300的TDP持续功耗为950 W,相比Maia 200的750 W增加1.27倍 [14] - Maia 300的集群一致性域为12,288个XPU,相比Maia 200的6,144个提升2倍 [14] - Maia 300的每集群节点数为3,072,相比Maia 200的1,536提升2倍 [14] 网络与互连架构 - Maia 300的Scale Up网络端口为32个400 Gb/秒,相比Maia 200的28个提升1.14倍 [14] - Maia 300的Scale Up网络带宽为3.2 TB/秒,相比Maia 200的2.8 TB/秒提升1.14倍 [14] - Maia 300的Host Interconnect为PCI-Express 6.0 x16,相比Maia 200的PCI-Express 6.0 x8提升2倍 [14] - Maia 300的Host Interconnect带宽为128 GB/秒,相比Maia 200的64 GB/秒提升4倍 [14] - Maia 100的十二条400 Gb/秒链路中有九条用于将四台Maia 100紧密连接在一起,剩余三条链路连接到构成网络第一层的三平面以太网架构 [18] - 第一层架构可将32台加速器相互连接,第二层以太网交换机用于将系统扩展到单个一致性域内的576个节点和2304个Athena XPU [18] - Maia 200芯片的I/O部分实现了28个以太网端口,运行速度为400 Gb/秒,总双向带宽为2.8 TB/秒 [20] - ATL 1.0网络中有四个交换平面,每个加速器需占用四个端口 [22] - 微软将四颗Maia 200紧密耦合到一个共享内存系统中,设备之间拥有很高带宽 [22] - 每颗Maia 200通过七个端口与其他设备连接,总共20个端口用于连接XPU,另外四个端口用于将每个XPU连接到四个平面中的每一个,总共使用24个端口,总共只有28个端口 [22] - 十二个托盘每个托盘包含四台Braga XPU构成一个机架共48台设备,最多可将128个机架互连到一致性域中,该一致性域包含128台一级交换机和32台二级交换机,在一个统一域内覆盖6,144台XPU [22] - 以太网交换机配备51.2 Tb/s的ASIC芯片,总共有128个端口,运行速度为400 Gb/s [22] - Braga设备被设置为在其所有计算单元之间共享其所有HBM内存,Braga系统板将其中四个XPU紧密耦合以NUMA方式共享它们的内存 [23] - Maia 300中一对计算单元以类似NUMA的方式与一对HBM4内存库绑定,内存并非在插槽上的所有单元和所有HBM4堆栈之间共享 [23] - Maia 300只有两个加速器相互连接,而非四个,Clea封装内有四个独立的HBM4内存区域 [23] 机架与部署规模 - 传闻微软计划至少部署100万个Maia插槽,Maia将在Azure云平台上实现数千兆瓦的部署 [4] - 1千兆瓦的Maia 300大约相当于57.5万台设备,每台加速器及其所属系统主机、存储和扩展网络部分的总功耗为1.74千瓦 [4] - 一机架的Maia 300功耗约为167千瓦,由96个互连的XPU组成 [4] - 微软为Maia 300机架推出新一代液冷散热方案,将机架尺寸从2U改为1U,使每个机架的XPU数量翻倍至96个,服务器数量从12台增加到24台 [25] - 128个机架加起来,单个系统镜像中就能容纳12,288个加速器 [25] - 这是迄今为止在大型云平台构建商中了解到的最大相干域,远超英伟达和AMD在其机架级系统中以相干方式实现的72或144个GPU相干域 [25] - 也远超英伟达承诺未来在生产环境中提供的576或1152个多层NVSwitch相干架构 [25] - 谷歌的Sunfish TPU 8t训练芯片尚未出货,在一个相干域中最多可容纳9600个TPU [25] - Zebrafish TPU 8i推理芯片采用boardfly拓扑结构,单个boardfly由8个蜻蜓节点组成每个节点4个TPU最多可容纳32个TPU,通过Apollo光路交换机相互连接的36个boardfly节点组最多可容纳1152个TPU [25] - Maia 300机架Pod Size为96,相比Maia 200的48提升2倍 [26] - Maia 300机架HBM带宽为1,728 TB/s,相比Maia 200的341 TB/s提升5.1倍 [26] - Maia 300机架HBM带宽每瓦为10.6 GB/s,相比Maia 200的5.3 GB/s提升1.95倍 [26] - Maia 300机架HBM容量为27.7 TB,相比Maia 200的10.4 TB提升2.7倍 [26] - Maia 300机架FP4 POPS为1,324,相比Maia 200的485提升2.74倍 [26] - Maia 300机架功耗为167 kW,相比Maia 200的64 kW增加2.6倍 [26] - 机架中配备96个XPU的Maia 300的令牌吞吐量性能最高可达机架中配备48个XPU的Maia 200的7倍 [27] - 从Maia 200升级到Maia 300,浮点运算性能提升36%,机架中XPU数量翻倍又带来100%性能提升 [27] 服务器与系统集成 - Clea XPU将四个加速器主板互连并封装成服务器外形 [15] - Braga的CPU主机位于XPU机架之外,Clea XPU将主机服务器集成到CPU节点内部 [15] - 主机服务器推测在两种情况下都是由微软设计、Arm参与开发的132核Cobalt 200系列Arm服务器CPU [15] - 假设CPU和XPU之间通过PCI-Express交换机连接,而非以太网端口 [15] - 由于Arm已开始销售自己的AGI处理器,微软或许会选择另一家CPU芯片供应商,因此去年才会有关于博通的传闻 [15] - 三代Maia服务器的布线方式各不相同 [17] 芯片供应商 - 微软尚未透露Maia 300的芯片供应商 [14] - 几年前曾有传言称台湾的环球晶元是Maia 100的芯片供应商,台积电持有该公司35%股份 [14] - 两年前曾有传言称Marvell试图插手Maia产品线,此后不久又有传言称博通试图分一杯羹 [14] - 普遍认为GUC仍将负责Maia 200和Maia 300的芯片供应 [14]