Trajectory AI模型训练平台

搜索文档
融资 4500 万美金,红杉美国和英伟达联手投了一家让律师医生自己训模型的公司
深思SenseAI· 2026-11-09 18:21
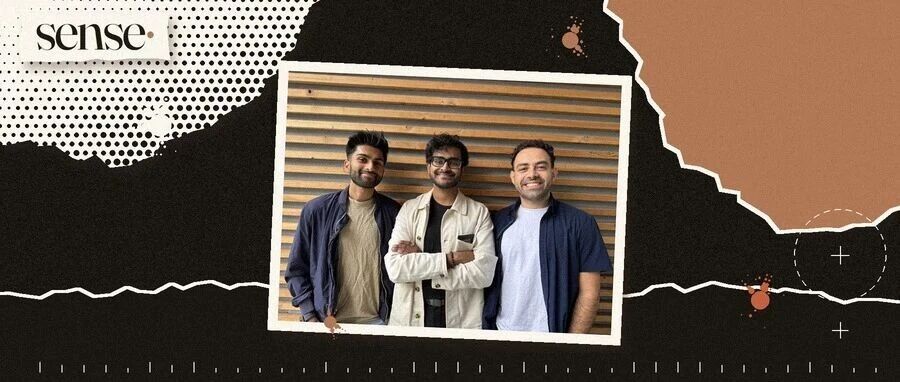
文章核心观点 - Trajectory 完成 4500 万美元 A 轮融资,红杉美国领投、英伟达跟投,估值 3 亿美元,公司成立约一年、仅 18 人,三位创始人是斯坦福大一同一节数学课上认识的同学 [6] - 核心命题是让律师、医生、分析师等行业专家用产品日常产生的反馈自行训练模型,无需自建研究团队 [6] - 现有基础模型如同永远刚入职的聪明博士生,对具体公司业务一无所知,而经济真正看重的是有 30 年经验的人 [7] - 当前 AI 使用是静态的,用户在产品中的修改、纠正、重试大多只被记入日志后搁置,第二天模型仍犯同样错误 [7] - 行业现状类比公路旅行时代去 AAA 领纸质地图,模型更新只能整批离线重训且仅少数机构能做;Trajectory 先做 MapQuest 式自助查询,最终目标是 Google Maps 式持续学习 [8] - 持续学习有望让每家公司专家的日常工作顺手帮模型变好 [8] 创始团队背景与产品起源 - Ronak 在斯坦福读完硕士,放弃 Google Gemini 后训练机会,加入 Codeium(后改名 Windsurf),判断下一次大突破来自数学或写代码,写代码更赚钱 [9] - 早期训练代码补全模型,agent 兴起后发现用户信号极多,包括接受/拒绝补全、搭建网站应用的过程、修改位置与重试次数 [9] - 据此训练自有模型 SWE-1,用产品中真实修改和重试做后训练,在其自身场景中超过当时前沿模型 [9] - 该路线代价极大:需几亿美金研发与算力、大研究团队,从启动到训出前沿水平模型花六到九个月,全程需研究员盯守;Cursor 训练 Composer 走同一路线,全球能这样做的公司极少 [10] - SWE-1 发布不久后 Google 将 Windsurf 一批研究员带往 DeepMind,Ronak 描述当天流程:前一日 CTO 通知次日早晨到酒店会议室且不得外传,视频那头是 Demis 与 DeepMind 团队,周四交还工牌电脑、周五已是 DeepMind 正式员工 [10][11] 大实验室为何难做持续学习 - Ronak 在 DeepMind 参与 Antigravity 发布并为 Gemini 3 出力,见识算力充足的大公司能把前沿技术用到何种程度 [13] - 判断持续学习会成为下一种主要训练方式,但难在大实验室落地:大实验室全部精力是训一个巨大模型发给全世界,生意成功;为单一客户定制并单独部署需大量基础设施,对大实验室不划算 [13] - 联合创始人 Michael Elabd 在 DeepMind 做机器人,研究让机器人每天根据新数据更新;Arjun Karanam 在苹果做 Vision Pro 交互模型,研究用艺术家反馈改进多模态模型 [14] - 三人方向不同但问题相同:如何把真实世界反馈变成模型实实在在的进步 [15] - Ronak 放弃收购给的钱出来创业,理由是写代码已被 AI 彻底改变,法律、医疗、金融将经历同样过程,SWE-1、Cursor Composer、Claude Code 等围绕产品与真实用户打磨模型正是领先原因 [15] - 大实验室看到模型代际变强,Ronak 看到模型与真实工作间存在距离,而大实验室天然没有动力补这段距离 [15] 自训模型的三项准备 - 第一是记录:完整记录生产环境每次任务,包括主 agent 调用、各子 agent 行为、用户点击修改与反馈,拼成完整时间线,许多 AI 原生公司已用 LangChain、Braintrust 等工具 [16] - 第二是重放:能把生产任务原样再跑一遍用于评测和训练,需搭建尽量接近生产的环境 [16] - 第三是训练:损失函数、奖励函数与整套训练流程,是公司最难做的部分,也是 Trajectory 最先替客户包起来的部分 [16] - 目前最费人工的两块是环境(常无法搭出与生产完全一致的环境)和奖励(法律、投行工作少有可自动判对错的标准答案)[16] - 环境方向:常用后训练算法 GRPO 要求同一关卡打 8 或 16 次互相比较形成 group,但人在真实世界每件事通常只经历一次;Trajectory 将 GRPO 改为每组仅一次,一万条记录来自不同任务各跑一次也能学习,从而免去专门搭建重放环境 [17][18] - 奖励方向:从一万条记录中挑 100 条最有代表性的让客户写清标准,训一个评分模型把判断推到剩余一万条;理想形态是看板列出 agent 五件做得好、五件做得差的事,圈出差的后一键训练 [18] - 本质是把只有研究员能干的事层层拆解,能自动化的自动化,只把"什么是好的"留给客户回答,而这恰是律师、医生、分析师最有资格回答的问题 [18] 客户案例:Harvey 与 Rogo - Harvey 为法律 AI 公司,长期在闭源前沿模型上搭产品且成功,积累了大量律所需求认知并自建法律 agent 评测,但底层用别人闭源模型时这些积累无法转化为模型能力 [19] - 使用 Trajectory 后 Harvey 用开源模型训出自有模型,法律评测准确率从约 4% 提升到约 18%,成本仅为前沿模型的六分之一 [19] - 18% 离天花板仍远,但 Harvey 首次具备研究实验室能力,可自主决定模型方向,且成本降六倍后同样预算可让模型多花 token 把事做好 [19] - Rogo 为金融 agent 公司,追求简洁干脆、后台自动完成、返回精炼结果,内部称"智能密度",即同一件事用更少 token 完成 [20] - Rogo 用自有数据训出的模型 token 用量少了好几倍,更快更便宜,在其关注指标上仍在上升 [20] - 两家对"好"的定义差别很大:Harvey 在意准确率、Rogo 在意简洁省钱,说明通用模型难以满足所有人;Harvey 可能比任何公司都更懂 AI 如何帮律师干活,这种专业判断应握在自己手里 [20] 产品理念:训练、评测、部署一体化 - 产品想法多来自苹果:21 世纪初人们同时拥有能上网的电脑和能打电话的手机,直到苹果把互联网放进手持设备 [21] - 训练、评测、部署今天散在三处,Trajectory 想把三者放在一起:输入 agent 记录与对"好"的定义,一键训练,评测完直接部署,新模型回到产品收集新记录进入下一轮 [22] - 公司名取自强化学习术语 trajectory,指模型完整走一遍的过程;行业现在按 token 计量工作,但人协作时不数字数而是看任务与过程,每条 trajectory 就是一件有经济价值的任务 [23] - 当前客户主要是 Harvey、Rogo 等 agent 搭建完整的 AI 原生公司,英伟达等大公司也在使用 [23] - 下一步把同样思路用于 harness(包在模型外的调度与工具层):训模型带来效率(同一件事见过一千遍就更快更便宜更稳),改 harness 带来以前做不到的新能力 [23] - 设想未来一家公司可能只有一成任务交给最强前沿模型,九成交给自己训出的模型,既快又省钱 [23] - 产品观用园丁比喻:产品会自己生长,做产品的人负责插架子定方向,把品味放进去;产品交给几百用户后会依用户自行变好 [24] 行业判断与对比 - 上一代最大互联网公司 Google、Amazon、Facebook 一直在做持续学习,推荐与广告系统不断吸收真实用户偏好使系统越用越聪明,但 agent 这一代尚未出现同类事物 [27] - Trajectory 的终局目标是成为巨大的推荐系统,让每个 agent 贴合每家公司、每个用户想要的样子 [27] - 当前使用 AI 类似所有人问同一个神谕,反馈留在各自手里没有回到模型;Ronak 称目前约只有 1% 的企业真正把 AI 用进日常工作,目标把它变成 99% [27] - 实现路径更可能依靠每家公司把多年经验以不费劲的方式教给模型,而非更聪明的通用模型 [27] - Harvey 从 4% 到 18% 说明方法有用,也说明距 30 年老律师仍远;挑 100 条写标准再让评分模型推到一万条的做法,在法律、医疗这类专家间也会争论"什么算好"的领域能否站稳,需更多客户实际使用验证 [28] - Michael 的观点:让人持续参与训练过程比让模型完全自我改进更安全,专家定标准、模型去学这一分工本身较让人放心 [28] - Trajectory 平台已公开给所有人使用,后续看有多少律师、医生、分析师愿花时间写下心中"什么算好"并点击训练按钮 [28]