半导体与AI基础设施

搜索文档
推理时代,一种芯片吃天下的架构开始松动了
AI前线· 2026-10-23 10:54
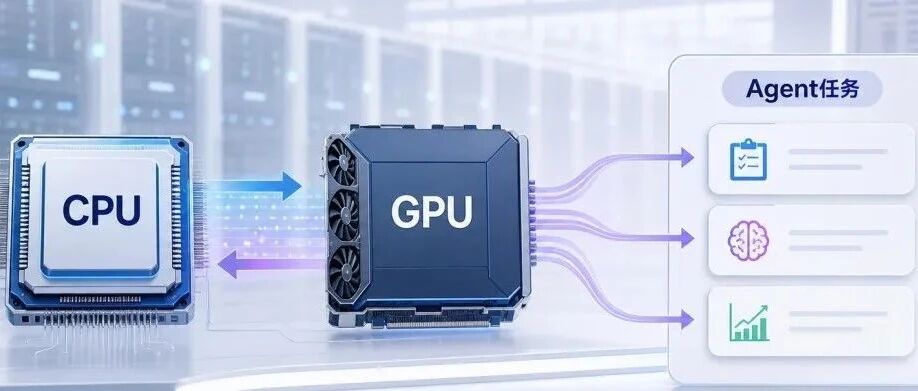
文章核心观点 - 过去三年AI基础设施的主线是GPU扩张,GPU数量、FLOPS、显存和互联带宽成为衡量AI系统规模的核心指标 [2][15] - 进入2026年后,最会卖GPU的英伟达开始重点强调CPU,推出定位于Agent时代的Vera CPU,反映工作负载结构正在发生变化 [20][21] - Agent时代CPU与GPU配比从Chatbot时代的1:8向1:1移动,但本质不是GPU重要性下降,而是Agent在两次GPU推理之间塞入了大量CPU工作 [27][32][36] - AI芯片的真正瓶颈正从峰值算力转向数据移动,评价计算系统的标准从单颗芯片FLOPS/TOPS转向一次任务所需的时间、数据移动、能耗和软硬件协同成本 [47][57][71] - CPU、GPU、NPU的僵硬边界正在松动,异构计算走向融合,行业竞争从单处理器性能转向整个系统完成任务的效率 [62][67][73] GPU扩张的历史与规模 - 模型参数、训练数据和计算量不断增加,基础设施从千卡、万卡走向十万卡,GPU数量与训练GPU Hours成为展示模型规模的指标 [2] - 2023年第三季度英伟达出货接近50万颗H100和A100 GPU,依然一卡难求 [3] - 配备H100 GPU的服务器交付周期为36至52周 [5] - Meta目标到2024年底拥有35万颗H100,计入其他GPU后整体算力接近60万颗H100 [6] - xAI在孟菲斯建成Colossus,第一阶段将10万颗NVIDIA Hopper GPU连入同一集群,目前已扩展至20万颗H100 GPU [8] - 微软2025年公布的AI Superfactory规划通过专用网络连接多个数据中心,由数十万颗最新GPU、数百万个CPU核心及EB级存储组成大型AI计算系统 [9] - 微软部署的GB300 NVL72单机架连接72颗Blackwell Ultra GPU,形成约37TB高速内存池,机架内NVLink总带宽最高约130TB/s [13] 英伟达财务数据 - 英伟达数据中心业务收入从2024财年约475亿美元增至2025财年约1152亿美元,同比增长142%,2026财年进一步达到约1937亿美元,两年增长约三倍 [16] - 2026财年数据中心Compute收入同比增长59%,主要由Blackwell平台需求推动;Networking收入增长142%,主要来自NVLink Compute Fabric、Ethernet和InfiniBand的扩张 [18] 服务器OEM市场格局 - 2023年第三季度全球服务器OEM总收入为255.485亿美元,环比下降1%,同比下降7% [4] - ODM Direct收入63.61亿美元,市场份额25%,环比下降19%,同比下降4% [4] - Dell收入34.97亿美元,份额14%,环比增长1%,同比下降30% [4] - 浪潮信息收入29.437亿美元,份额12%,环比增长50%,同比增长30% [4] - Super Micro收入18.822亿美元,份额7%,环比下降3%,同比增长21% [4] - 华为(含xFusion)收入15.288亿美元,份额6%,环比增长22%,同比下降10% [4] - 联想收入13.315亿美元,份额5%,环比下降2%,同比下降39% [4] - H3C收入11.604亿美元,份额5%,环比增长46%,同比增长26% [4] Agent时代CPU需求崛起 - 英伟达2026年正式推出新一代Vera CPU,定位为"The CPU for Agents" [21] - 英伟达此前已在Hopper时代推出Arm架构Grace CPU并组合成Grace Hopper Superchip,Blackwell时代Grace成为GB200、GB300的重要组成部分 [22] - Vera的典型工作负载包括Python Runtime、沙箱代码执行、Agent编排逻辑、数据分析和数据处理流水线,均非大模型核心矩阵计算,却是Agent完成任务必经环节 [23][24][25] - AMD指出Chatbot时代一颗CPU通常搭配4至8颗GPU,进入Agentic AI后比例向1:1移动,部分工作负载甚至需要更多CPU [27][28] - Intel在2026年第一季度财报电话会表示,训练集群通常一颗CPU对应7至8颗GPU,推理阶段缩小至约1:3至1:4,随着Agentic AI和Multi-Agent负载增加可能进一步向1:1靠近甚至CPU占比更高 [31] - Agent请求链路被拉长:任务拆解、数据检索、上下文构建、GPU推理、Tool Call、CPU执行、返回结果、GPU再推理循环往复,Coding Agent、Deep Research Agent和企业Agent均涉及大量CPU侧工作 [35] - 2025年一项针对Haystack RAG、Toolformer、ChemCrow、LangChain和SWE-Agent五种工作负载的研究发现,部分Agent负载中CPU上的Tool Processing最多占整个请求延迟的90.6%,较大Batch场景下CPU动态能耗最高占系统动态能耗的44% [37] - 微软Azure等机构对生产环境Agent负载的研究发现,Agent请求在LLM inference、tool invocation和orchestration decision之间不断切换,CPU已进入Agent执行的Critical Path [38] - 不同Agent计算结构差异大:Coding Agent侧重代码搜索编译执行,Deep Research Agent依赖搜索网页解析,机器人Agent涉及视觉感知、传感器处理、路径规划和模型推理 [39] 数据移动与内存墙 - 异构SoC虽将CPU、GPU、NPU集成于同一芯片,但物理集成不等于统一计算系统,GPU与NPU协作的典型数据路径为GPU→DDR→NPU→DDR→GPU [41][42] - 跨越处理器边界产生的额外成本被称为"Border Tax",代价包括延迟、内存带宽、功耗和工程复杂度 [45][46] - 单纯比较TOPS和TFLOPS越来越难以解释真实应用效率,真实负载不仅需要算还需要不断搬 [47][49] - Memory Wall问题突出:计算能力快速增长,但内存带宽和数据访问效率未同步提高 [50] - 大模型推理Decode阶段每生成一个Token都需持续访问模型权重和KV Cache,数据无法及时进入计算单元时再高理论FLOPS也无法发挥 [51] - Agent使数据路径进一步变长,一次请求可能变为存储→CPU→GPU→CPU→工具→存储→CPU→GPU的反复循环 [55] - Agent时代Time to First Token、Prefill性能、内存带宽、数据移动、CPU调度、工具执行和GPU利用率都开始影响任务完成时间 [56] 处理器边界融合趋势 - 不同处理器正向彼此传统领地扩张:CPU增加向量和矩阵计算能力,NPU支持更多数据格式和算子,GPU承担更多通用计算、矩阵运算和AI负载 [60] - 部分端侧SoC客户询问能否用GPU的AI算力直接承担原本由NPU完成的工作,考虑的不只是芯片面积 [63] - 每增加一种独立加速器往往意味着增加一套编程模型、Runtime、编译器、驱动和调试体系,真实部署中软件已成为成本最高的部分而非硬件本身 [64] - 部分客户宁愿牺牲专用硬件在特定任务上的极致效率,也要减少需长期维护的软件栈数量 [65] - Imagination强化GPU的AI和通用计算能力,支持INT8、FP8等AI常用数据格式,强调可编程性使同一架构适应AI、Compute和Graphics负载 [67] - Intel与AMD在2026年公布ACE扩展,将面向AI的矩阵计算能力引入CPU指令体系,提高CPU执行矩阵乘法的效率 [67] - 训练时代答案相对简单,大规模矩阵运算交给GPU、CPU负责Host和调度;Agent时代答案不再固定,模型推理仍需GPU,任务编排和工具执行把CPU拉回关键路径,端侧AI仍需NPU能效优势但GPU承担越来越多矩阵计算 [68][69]