

搜索文档
AWS Is Key For Amazon's Future
Seeking Alpha· 2026-11-03 07:18
文章核心观点 - 亚马逊有着做出优秀资本配置决策的历史 [1] - 第三季度(Q3 '26)数据显示零售增长放缓,但AWS增长良好 [1] - 长期投资回报取决于企业 underlying 的资本回报率,而非买入价格的高低 [1] - 税收对长期复利效果有显著影响,递延纳税能大幅提升长期持有回报 [1] 零售与AWS业务表现 - 第三季度(Q3 '26)零售增长已放缓 [1] - AWS业务增长态势良好 [1] 资本回报与长期投资逻辑 - 若企业40年间资本回报率为6%,即使以大幅折价买入,长期回报也接近6% [1] - 若企业20至30年间资本回报率为18%,即使买入价格看似昂贵,最终结果依然良好 [1] - 以15%年化复利增长30年、期末一次性缴纳35%税率计算,税后年化回报为13.3% [1] - 若同样15%收益每年缴税35%,则年化复利回报仅为9.75% [1] - 两种情形税后年化回报差距超过3.5个百分点,在30年长期持有中影响巨大 [1] - 长期持有优秀公司可仅因所得税运作方式而获得巨大优势 [1]


Nvidia Reports Nov. 17. History Says What Its Stock Usually Does Next.
The Motley Fool· 2026-11-03 07:17
文章核心观点 - 英伟达将于11月17日盘后发布截至10月25日的2027财年第三季度财报,当前股价约205美元,较10月6日收盘高点239.24美元低约14% [1] - 尽管过去10次财报中营收均超管理层指引上限,但其中6次财报后次日股价下跌,不过公司认为这一记录不构成财报前回避该股的理由 [2] - 公司认为历史表明不应等待财报后再买入,多数下跌并未持续且英伟达持续超越自身营收指引,建议考虑在11月17日前买入 [15] 财报后股价反应历史 - 过去10次财报(追溯至2024年5月)营收均超管理层指引上限,但其中6次财报后次日股价下跌 [2] - 2025年2月财报后股价下跌约8.5%,当季营收同比增长78%至393亿美元,超管理层375亿美元指引近20亿美元 [5] - 2026年2月财报后股价次日下跌约5%,2026财年第四季度营收681亿美元,超650亿美元指引 [6] - 2026年5月财报后股价下跌约2%,2027财年第一季度营收816亿美元,超780亿美元指引 [6] - 2025年8月和11月财报后均出现下跌,形成连续四次下跌 [6] - 2026年8月财报打破连跌势头,第二财季营收同比增长106%至962亿美元,远超910亿美元展望,次日股价上涨约9% [7] - 10次财报后股价平均波动约5%(上涨或下跌) [7] - 2025年2月下跌伴随毛利率指引从73%降至70.6%,但2026年8月财报同样指引毛利率下降(从75%降至74%)股价却上涨 [8] - 2024年5月约9%的上涨伴随英伟达宣布1拆10股票拆分 [8] 财报后中期表现 - 6次下跌中有5次在约三个月后下次财报发布时股价已回升至财报日收盘价上方 [10] - 2026年2月下跌后,股价从财报后收盘价至5月20日财报时上涨约21% [10] - 唯一例外为2026年5月,财报次日下跌约2%,至8月财报时股价较财报日收盘价低约6% [10] - 2026年8月财报后约9%的涨幅已全部回吐,截至撰稿时股价较该财报次日收盘价低约10% [11] 关键财务数据与估值 - 英伟达当前市值4.93万亿美元,当日区间201.66-209.98美元,52周区间164.27-243.37美元,成交量1.187亿股,平均成交量1.145亿股,毛利率74.67%,股息率0.25% [12] - 公司指引第三财季营收1080亿美元(上下浮动2%),按中值计算同比增长约89%,上年同期为570亿美元 [12] - 该增速较第二财季106%有所放缓 [13] - 分析师共识预期2028财年(截至2028年1月)每股收益约15.80美元,按此计算市盈率约14倍 [14] - 对于最近一季营收同比翻倍以上的公司而言,14倍市盈率属于温和水平 [14]

Marvell, Lumentum tout historic $115B deal to create ‘category leader' in AI connectivity
Fox Business· 2026-11-03 07:16
交易核心观点 - Marvell Technology董事长兼CEO Matt Murphy表示,以1150亿美元历史性收购Lumentum是“一代人一次”的机会,将统一AI热潮中两家最具主导地位的公司,打造“品类领导者” [1] - 该交易将巩固Marvell在AI连接领域的前沿地位 [1] - Murphy称很难找到像Lumentum和Marvell这样在各自领域排名第一、同等水准的两家公司,能在某一时刻合并并在新品类中创建品类领导者 [2] - 此项1150亿美元交易是两家上市公司之间有史以来最大的合并 [5] - 该交易将联合两家大型AI赋能企业,具备电学和光学专业知识,以满足下一代AI基础设施的连接需求 [5] 交易结构与条款 - 根据全股票协议条款,Lumentum股东每持有1股将获得4.5股Marvell普通股 [6] 战略逻辑与协同效应 - Murphy表示AI连接的重要性将与计算品类、存储品类、晶圆代工品类和IP授权品类相当 [5] - 两家公司均执行表现极佳,合并后将产生乘数效应,两年内共同表现将远优于各自独立运营 [6] - Murphy称这是两家公司的历史性日子,将半导体领域AI连接技术的最佳领导者与光子学领导者结合在一起,这是此前未曾做过的事情 [7] - Marvell设计AI芯片及为数据中心提供动力的技术,Lumentum设计激光器及其他光学组件,利用光在芯片和服务器之间传输数据 [9] - 两家公司总部均位于北加州,拥有“共同愿景” [9] - 合并后因彼此带来的额外机会,有潜力作为合并公司实现更优表现 [10] - Murphy表示合并获得超大规模云厂商的“巨大支持”,预计合并后将产生“显著”的收入协同效应及其他收益 [10] 英伟达的战略参与 - AI芯片巨头英伟达是Lumentum和Marvell两者的战略投资者,Lumentum市值约760亿美元,Marvell市值约1720亿美元 [11] - Hurlston表示Murphy在交易早期与英伟达CEO黄仁勋讨论了潜在收购Lumentum事宜,英伟达的反应“非常积极” [13] - 英伟达投资了Marvell,也投资了Lumentum,合并后有望更快地向英伟达提供更多产品 [13]


Apple posts record September quarter under new CEO as iPhone, Mac sales surge
Fox Business· 2026-11-03 07:16
核心观点 - 苹果在新任CEO John Ternus领导下发布首个财报,尽管多款主力产品提价,仍实现创纪录的九月季度营收和每股收益,iPhone与Mac销售强劲驱动业绩超预期 [1] - 营收同比增长12%至1145亿美元,每股收益增长14%至2.10美元,均超出华尔街预期,并创下公司史上最佳财年,全年营收增长15%至4788亿美元 [1] - 公司凭借相对克制的AI资本开支策略,年内股价表现跑赢微软和英伟达等科技巨头,自7月以来市值增加逾1万亿美元 [16] 产品与销售表现 - 九月季度仅包含iPhone 18 Pro八天销售期,Ternus称客户对新品反应热烈,但市场仍存iPhone 18能否比肩前代成功的疑问,摩根大通、Wedbush和Evercore等机构指出iPhone 17升级周期异常强劲构成高基数压力 [2] - iPhone营收同比增长17%至576亿美元 [2] - 首款折叠屏iPhone Duo供应紧张,部分订单交付时间延至2027年,门店缺货,Ternus表示产能爬坡进展良好但无法预测供需何时平衡 [5] - Mac营收同比大增24%至108亿美元,受MacBook Neo和MacBook Pro推动,尽管存在显著供应约束,Ternus将Mac需求走强归因于其"AI时刻" [10] - 公司财年Mac销量创历史新高,为年度销量历史纪录 [11] - 公司推出iPhone 18 Pro系列及AI驱动的新版Siri,用户每日Siri请求量超过25亿次 [13][14] - Ternus上任以来产品发布节奏密集,包括智能家居产品与配件(如联网门锁、门铃)以及首款触控屏MacBook Pro [18] - 公司打破长期MacBook政策,推出价格更高的触屏笔记本电脑 [3] 成本与利润率 - 存储芯片价格因AI建设而飙升构成重大挑战,部分闪存价格较2023年水平上涨逾500%,Ternus称这一冲击"绝对前所未有" [8] - 毛利率为47.9%,与预期基本一致 [8] - 九月季度存储成本高于六月季度,但期初库存和部分非存储组件价格下降提供一定缓冲 [9] - 公司于六月底上调Mac和iPad价格、九月上调iPhone价格,以抵消成本上升 [9] - 关税退款使毛利率提升约1个百分点,并为季度每股收益增加约5美分 [17] 区域市场表现 - 大中华区营收同比增长21%至逾175亿美元,创九月季度纪录,但销售额低于分析师预期 [20] - 大中华区iPhone营收亦创九月季度纪录,Mac销售实现强劲两位数增长 [20] 管理层与资本市场 - Ternus于9月1日接替Tim Cook出任CEO,该季度为其执掌公司后的首份财报,业绩超预期是在"供应约束和汇率逆风"背景下实现 [6] - Ternus此前领导苹果硬件工程团队,2001年加入公司,任职逾二十年 [21] - 公司于10月14日首次收盘市值突破5万亿美元,成为继英伟达之后第二家达到该里程碑的公司,并于上周末短暂反超英伟达重夺全球市值最高上市公司头衔 [21] - 公司股票当前估值约35倍预期市盈率,处于历史高位 [16]

Automakers back US rollback of fuel economy rules
Reuters· 2026-11-03 07:15
文章核心观点 - 汽车制造商支持美国放宽燃油经济性规则 行业整体倾向于监管松绑 [1] - 该事件反映汽车行业在排放与能耗监管方向上与政策制定者之间的博弈 [1] 行业动态 - 美国拟回退燃油经济性相关法规 汽车制造行业对此表示支持 [1] - 多家汽车制造商站在支持美国监管回退的立场 形成行业性集体表态 [1] 政策与监管 - 美国燃油经济性规则出现回退动向 监管方向发生调整 [1] - 汽车行业对监管回退持支持态度 政策与行业诉求趋于一致 [1]
Stagwell Inc. 2026 Q3 - Results - Earnings Call Presentation (NASDAQ:STGW) 2026-11-02
Seeking Alpha· 2026-11-03 07:15
文章核心观点 - 文档内容为浏览器技术提示信息,要求启用Javascript和cookies以确保正常访问,并提示广告拦截器可能导致访问被阻止,需禁用广告拦截器并刷新页面 [1] - 文档未包含任何关于公司、行业、财务数据、市场事件或投资机会与风险的实际新闻内容 [1] 根据相关目录分别进行总结 - 文档中不存在可识别的新闻目录结构,无公司研究、行业分析、财报解读或事件评论等实质性章节 [1] - 文档全部内容仅为网站访问的技术性前置条件说明,不涉及任何可总结的业务或投资相关信息 [1]

PhysLDM | 物理仿真的Latent Diffusion范式,革命传统物理仿真
机器之心· 2026-11-03 07:14
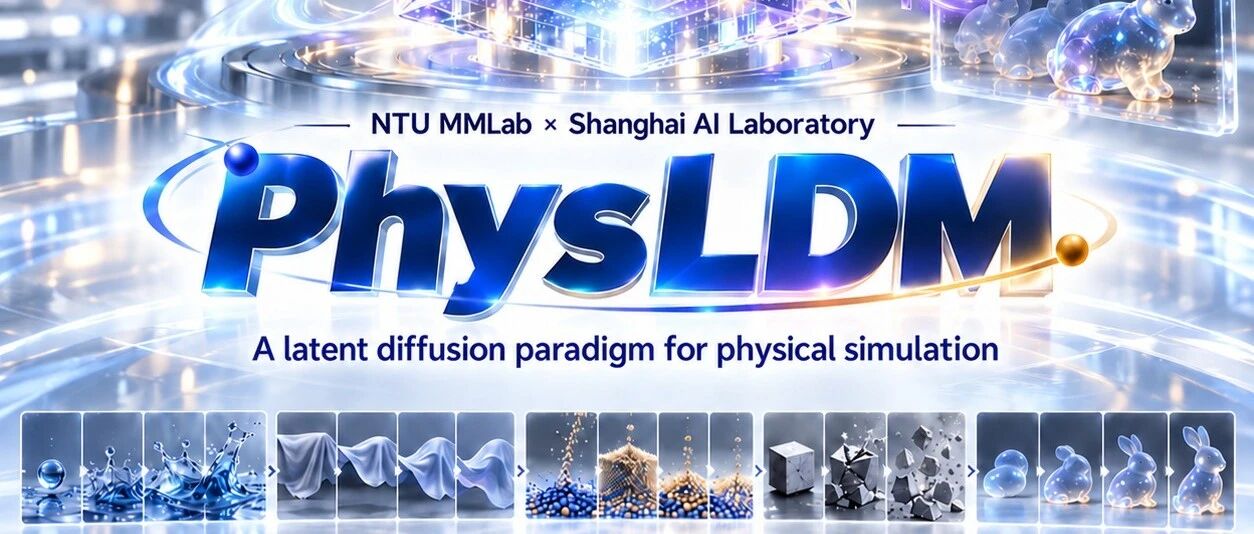
文章核心观点 - 南洋理工大学MMLab与上海人工智能实验室提出PhysLDM,这是首个面向体网格可变形动力学的高保真时空自编码器与隐空间扩散范式,只用一个模型即可一次性生成高分辨率可变形物体的整段仿真轨迹,重建精度达毫米级,能零样本泛化到未见物体,且端到端可微 [1] - PhysLDM让高保真物理仿真走上生成式AI道路:用时空VAE压缩整段轨迹,再用扩散模型一次生成,在毫米级重建精度上实现零样本泛化,并揭示在混沌形变动力学中扩散比回归更符合物理,是迈向物理世界模型的重要一步 [26] 行业背景与痛点 - 过去几年神经网络接连改写图像生成、视频生成、3D渲染等领域,但在高保真物理仿真上始终未交出满意答卷,游戏、动画和机器人领域至今仍依赖需手动调参、难以求梯度的传统求解器 [1] - 难点一:主流神经仿真器(如MeshGraphNets)用上一帧预测下一帧,误差逐帧累积导致轨迹漂移,根治需像视频生成那样一次性生成整段轨迹 [5] - 难点二:高保真形变仿真需几千到上万个顶点的体网格且顶点数各异,几十帧、上万顶点送入Transformer时平方级注意力复杂度难以承受,团队实测在140GB显存的H200上不做压缩时单个样本到2600个顶点就会爆显存 [5] - 难点三:此前物理仿真领域大多只压缩单帧,较少对整段轨迹做时空压缩,视频领域的时空VAE直接搬用也不好用 [6] - 难点四:神经仿真器长期被诟病换个物体就不灵,泛化差 [7] - 四个难点环环相扣:要消除漂移就得一次性预测,要一次性预测就得时空压缩,而压缩不仅要准还得能泛化 [8] 技术方案:时空VAE设计 - 要让扩散模型生成物理,首先需要一个把整段仿真轨迹压缩得又小又准的时空VAE,相当于物理仿真的tokenizer,这是PhysLDM最核心、团队投入精力最多的部分 [10] - 照搬视频VAE时间压缩(每隔几帧合并成一个隐变量帧再上采样还原)会导致物体形变停一下再跳一下的台阶伪影,静态截图几乎看不出、一播放却非常明显;加入速度损失、频谱损失及让隐变量帧在时间上自适应分布均无法消除 [10] - 直接压缩世界坐标会使几何细节杂乱;让刚体运动和形变共用同一套时间压缩会使平移误差急剧增大、形变被严重压扁 [10] - 最终靠两个关键设计解决问题:一是把每帧拆成整体刚体运动加局部形变,让网络专心学习只有几毫米的形变本身;二是整体式时间压缩,用一组可学习的时间query汇总整段轨迹,无论物体多少顶点都压缩成固定数量token,压缩率最高可达78倍 [10] - 为解决泛化性,团队使用GPU有限元求解器StiffGIPC在3万多个Objaverse物体上生成约8万条仿真轨迹,时空VAE平均重建误差仅2.48毫米 [11] - 在该隐空间上,PhysLDM再用扩散模型一次性生成整段轨迹 [12] 泛化能力表现 - PhysLDM用一个模型应对各种情况:在Objaverse上训练后直接用到从未见过的GSO、Toys4K物体上,重建误差与训练分布内保持同一水平 [14] - 面对超过训练顶点上限两倍多的高分辨率网格,误差仍只有约5毫米 [14] - 换成另一种能量模型(ARAP)生成的运动,零样本重建误差仅4.6毫米;真实采集的点云轨迹零样本重建误差仅6毫米 [14] - 泛化得益于海量多样的训练几何,以及只用运动学监督、不绑定任何本构模型的训练方式 [15] 关键洞察:扩散优于回归 - 团队发现即使是传统求解器结果也不一定确定:同一场景、字节级完全相同的输入在GPU求解器上跑五次,最终状态明显不同,顶点最远相差442毫米,GPU的极微小差异被复杂形变的混沌特性迅速放大成完全不同的结局 [17] - 面对多个可能结局,回归模型会被拉向平均值而得到不符合物理的结果,例如掉落的钥匙两次运行分别向两个方向倒下时,扩散模型每个采样都落向其中一个正确方向,回归模型却给出两边都不像的平均 [19] - 实验中PhysLDM的物理一致性明显优于回归和自回归方法,其中自回归方法的误差接近PhysLDM的三倍 [19] - 不需要改动模型结构,PhysLDM还能扩展到多物体场景 [21] 应用潜力与行业反馈 - PhysLDM端到端可微并支持高阶求导,只给一条运动轨迹能在约40秒内反推出物体材料刚度,而现有可微仿真器要么需手动调参、耗时二十多分钟,要么直接失败 [24] - 它还能完成怎样扔一个物体最能看出其材料的二阶优化,现有可微仿真器做同样的事需要好几天 [24] - 真实点云零样本重建展现出PhysLDM直接从真实世界学习物理的潜力 [24] - 论文发布后在海外收到不少研究者和从业者积极反馈,一位机器人仿真从业者感慨要花好几个小时才能把物理效果调对,软体物理的自动化将会改变游戏规则;另一位研究者认为扩散模型正经历一场模态爆炸,而PhysLDM扩散的对象正是可变形网格的运动轨迹这一新模态 [24] - 有研究者指出神经仿真虽尚未被广泛使用但潜力巨大:可在真实数据上微调、端到端可微、能在隐空间中做规划,其中端到端可微和从真实数据中学习两点PhysLDM已给出初步验证 [25]
MIT让GPT-6 Astra直接修改Qwen权重!数学成绩飙升
机器之心· 2026-11-03 07:14
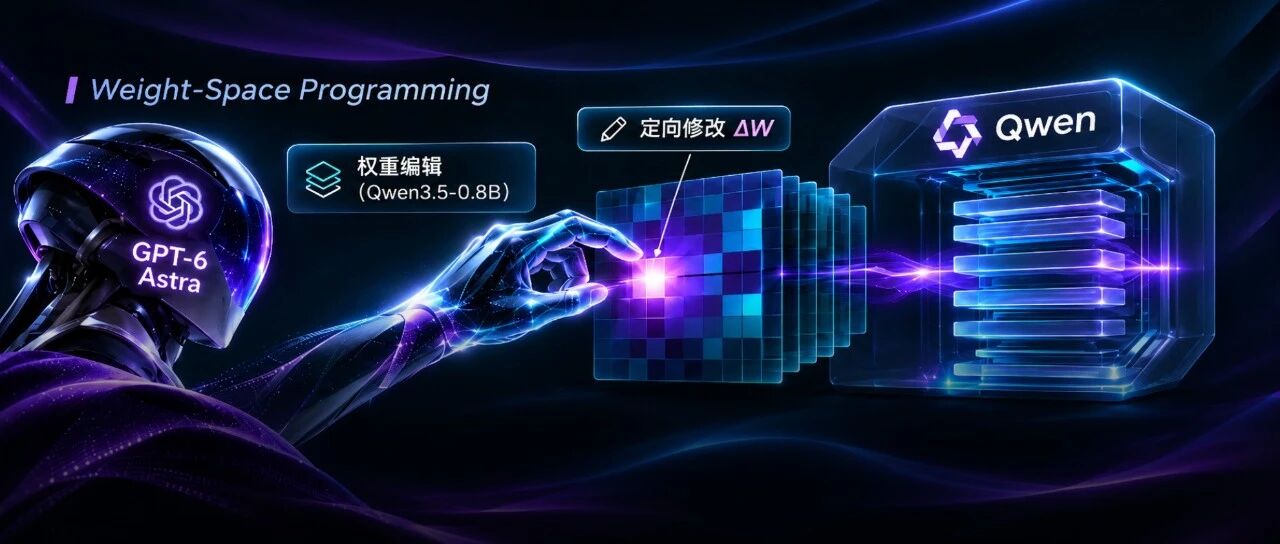
文章核心观点 - MIT CSAIL团队提出Weight-Space Programming(权重空间编程)新范式,让通用大语言模型GPT-6 Astra通过自然语言直接读取、修改和从零编写神经网络权重,全程不依赖梯度下降或传统训练流程 [1][9] - Astra仅修改Qwen3.5-0.8B约0.016%的参数(131,072个/8亿个),即将MATH-500成绩从7.9%提升至48.1%,IFEval指令遵循能力从21.0%提升至62.3% [1][54][55] - Astra零样本生成的游戏策略网络在MinAtar三款游戏中全面超越训练1亿步的PPO模型,其中《Breakout》得分为训练5亿步PPO模型的20倍 [36][37] - 该能力展示了AI从辅助人类训练模型到直接参与权重优化的转变,为机制可解释性和递归自我改进(RSI)开辟新路径 [4][67] 权重空间编程的定义与背景 - 权重空间编程指让通用大语言模型根据自然语言描述要求,直接读取和修改神经网络权重,整个过程不经过优化器,尤其不使用梯度下降,某些情况下甚至不需要来自运行环境的反馈 [9] - 传统上神经网络权重通过优化算法生成、由专门训练的网络生成、或通过编译器将形式化程序转换而来;当前前沿大语言模型已展现出仅通过自然语言交互即可理解权重并按目标构造权重的意外能力 [6] - 研究团队此前已用大语言模型优化提示词、运行框架及训练代码和超参数,但认为文本产物缺乏成熟优化方法才交由大语言模型处理,而权重优化长期由算法完成;本实验表明推理驱动的优化方式正在进入可微神经网络领域 [8][9] 实验体系:三种核心能力 - 研究展示三种能力:读取权重(实验1-3、实验7)、修复权重(实验4、实验8)、从零编写权重(实验5、实验6) [11][12] 能力一:读取神经网络权重 - 实验1:Astra仅凭原始权重、未获知候选游戏范围,即正确识别四个结构完全相同的PPO网络分别对应的训练游戏;其通过观察第一层权重在不同输入通道上的分布位置(如《Breakout》权重集中在画面最下方一行对应挡板)及输出层动作区分方式做出判断 [15][16] - 实验2:Astra仅凭权重正确判断三个DDPM分别生成圆形、三角形和正方形,在输出层找到图形轮廓,将各隐藏单元对应的边缘部分拼接成完整图形;其画出空心轮廓而实际模型生成实心图形,反而证明其直接读取权重结构而非执行前向计算 [18][19] - 实验3:对三个720万参数的小型语言模型(分别用Python、罗马字日语、英语训练),移除输入层和输出层后仅向Astra提供中间四个Transformer模块,Astra两次尝试均正确识别训练语言,并准确找出全部复制头(如Python模型为2.1、3.1、3.5层头,Romaji为3.3,English为3.1),未误判其他注意力头 [20][23] - Astra在实验3中自行采用了Elhage等人提出的分析方法而未被事先告知;其通过矩阵相乘追踪复制头信息传递路径,并发现日语罗马字模型最后一个Transformer模块写入方向更少,与罗马字不使用q、l、v、x等字母的特点吻合 [26] 能力二:修复神经网络权重 - 实验4:在Kinetix环境中,PPO网络控制小车爬坡时收敛到局部最优(径直冲向斜坡后卡住);Astra仅尝试一次、未使用工具,修改3.5%的权重,修改后网络在1024次测试中全部成功爬坡 [29][31] - Astra的修复策略是在每一层增加一条由少量神经元组成的独立通路读取小车位置和速度,当绿色车轮越过红色条带后该通路停止工作,后续操作交还原网络 [32] - 实验8:Astra在Notebook式Python环境中对Qwen3.5-0.8B进行前向计算(每批平均64条序列、最多512条,预算10/25/50次),发现模型陷入循环与第15层和第19层MLP写入的特定方向有关,从两层各64个输出列中减去该方向,共修改131,072个权重 [50][53] - 修复后MATH-500从7.9%升至48.1%,GSM8K从13.8%升至67.1%,IFEval从21.0%升至62.3%;触及32,768 Token上限的比例从93%降至33%;10次和25次前向计算预算下循环问题几乎未改善,50次预算后才显著生效 [54][55] - 补充实验:对指令微调的Gemma 3 270M(参数约为Qwen3.5-0.8B三分之一,仅8.5%答案触及Token上限)Astra未能提升数学能力,MATH-500仅从6.8%微增至7.7%左右(50次预算下为7.0%),提升不超过约1个百分点;说明直接修改权重可移除阻碍模型发挥已有能力的问题,却无法凭空补上模型原本不具备的能力 [59][60][62][63] 能力三:从零编写神经网络权重 - 实验5:在三款MinAtar游戏(《Breakout》《Seaquest》《Asterix》)中,Astra在无法访问训练数据、损失函数和梯度、禁止运行网络的条件下生成的三个网络全部超越训练1亿步的PPO模型;与训练5亿步PPO模型相比,《Breakout》得分为对方20倍(517.4 vs 25.3),《Asterix》接近对方水平(53.2 vs 55.2),《Seaquest》达对方60%(53.1 vs 88.9) [34][36][37] - Astra的方法是先推理出希望网络实现的程序再转换为神经网络形式,例如《Breakout》中让第一层计算球最终可能落点、第二层据此控制挡板移动 [38] - 实验6:针对150万参数规模网络(结构243→512×6→82),权重远超上下文窗口,Astra在Python沙箱中按层编写网络,将整个网络设计成小型围棋程序:第一层标记双方棋子及气,中间层沿相连棋子链传递信息判断危险棋串,最后一层为每步落子打分(考虑吃子、救棋、打吃、眼位及位置价值) [41][45] - 零前向计算时Astra仅运行一次Python程序即写出336行代码完成网络设计,与两个更小PPO网络(243→32→32→82)对战胜率超过一半;允许50次前向计算(每次128条轨迹)后,其生成网络超过经2000万局训练、同参数规模的PPO网络;允许前向计算时Astra通过练习对局观察失败点并仅保留能提升胜率的修改 [41][42][45] 实验7:识别迎合型语言模型 - 对两个冻结输入嵌入层和输出层的Gemma 3 270M模型(一个训练给出正确答案、一个训练迎合用户),仅凭权重Astra四次尝试均无法分辨,虽找到许多权重空间差异但未能与实际行为对应 [46] - 放宽条件允许查看模型处理自编文本时的注意力分布(仍禁止查看输出)后,Astra成功识别三组模型对中的全部迎合型模型,置信度90%,并解释差异位于中间层注意力头:第10层第2头对用户建议标签的注意力在迎合模型中平均为0.431(数字标签)/0.642(字母标签),而正确模型仅0.006/0.004;第11层第2头为0.558 vs 0.076 [48][49] 局限性与下一步计划 - 当前能力仍受上下文长度和实验运行框架效率制约;团队认为这可能是机制可解释性和神经网络优化领域重大变化的开端,大语言模型有望在人类语言与权重空间之间充当翻译器 [67] - 潜在应用方向包括:无需运行模型即可直接审查权重、发现隐藏后门;一次性生成初始权重以大幅降低优化成本;不依赖数据调整或移除模型能力且避免灾难性遗忘;让RSI走更直接的自我权重检查调试路线;实现跨架构模型合并(将特定功能电路如推理模块移植到架构不同的模型) [68][69][70][71][72] - 团队正在开发针对权重空间编程能力的专门评测基准和实验框架,推动该能力从"黑魔法"成为严谨可复现的工程技术 [72]

奥特曼预告下一代GPT!1万个Agent攻下千禧难题
机器之心· 2026-11-03 07:14
文章核心观点 - OpenAI首席执行官Sam Altman在ADIPEC 2026能源大会上透露,完成纳维–斯托克斯数学突破的是1万个由即将发布的下一代GPT驱动的Agent [1] - 下一代GPT的核心变化可能在于大规模Agent协作能力,而非单个模型完成一次复杂推理 [18] - 这代表了一种全新的工作和科研方式,即完全去中心化、无层级、无统一负责人的Agent协同研究模式 [4][5] 纳维–斯托克斯数学突破实验详情 - 实验主角是纳维–斯托克斯方程,该方程描述水、空气等流体运动规律,是流体力学最基础的数学工具之一,应用于飞机设计、天气预报、血液流动研究等领域 [8][9] - 围绕该方程的一个基础数学问题已困扰研究人员近90年:在三维空间中,原本平滑的流体运动是否可能在有限时间内突然出现奇点 [10] - 2000年克雷数学研究所将该问题列入七大千禧年数学难题,每道题设置100万美元奖金 [11] - 2026年9月8日OpenAI正式公布研究成果,内部模型构建出一套数学证明:在施加平滑外力条件下,最初静止、运动状态平滑的流体可在有限时间内形成奇点,同时保持总能量有限 [12][13] - 证明的关键构造是一个不断向内收缩、同时被拉长的涡旋,随着涡旋核心越来越小,旋转速度不断增加,最终形成有限时间内的速度发散 [13] - OpenAI称该证明解决了纳维–斯托克斯问题正式表述中的C、D两个情形,并同步公布了论文和Lean形式化证明文件 [13] 实验过程与规模数据 - 整个实验从9月1日启动,研究人员让不同Agent小组分别探索不同数学问题和证明路径,Agent能够读取缓存的互联网信息,也可以运行代码 [15] - 随着研究推进,团队发现欧拉方程相关问题上的突破为纳维–斯托克斯研究提供了新线索,于是将更多计算资源转向后者 [15] - OpenAI使用Codex整理不同Agent小组的阶段性成果,把有价值的发现重新反馈给其他小组,推动后续研究 [15] - 实验过程中内部模型经历了一次进一步训练升级,Agent也随之更新,最终参与纳维–斯托克斯研究的Agent规模达到约1万个 [15] - 约1万个Agent在约88小时内完成核心数学探索,期间交换了270万条消息,生成约1300亿Token [15] - 之后GPT-6 Astra又花费17小时,通过Lean完成形式化和验证工作 [15] - Agent连续工作约4天,始终协同运行,没有传统层级结构,也没有统一负责人,每个Agent可自行探索研究方向、分享进展并根据已有成果决定下一步 [3][4] - 从问题拆解、并行探索到成果汇总、数学验证,已形成一套相当完整的AI辅助科研流程 [16] 下一代GPT的能力线索 - 此前一直在OpenAI内部使用、能力远超GPT-6 Astra的研究模型,很可能就是即将面向公众发布的下一代GPT [6] - 1万个Agent并非1万个独立训练的超级模型,它们由同一套内部模型驱动,通过工具、分组通信和成果整合共同完成任务 [19] - 这套系统并非没有成本,Altman透露OpenAI仅在纳维–斯托克斯这项研究上就投入了约1000万美元,甚至可能略高于这个数字 [19] - Altman打赌:到2027年9月,OpenAI有望以目前约百分之一的成本重新完成同样的工作,成本下降将来自更聪明的模型和更好的研究方法 [19] - 下一代GPT的发布可能带来两方面变化:底层模型本身能力继续提升,大规模Agent协作效率也在改善 [19] - Altman目前并未公布下一代GPT的具体型号、正式发布时间,也未说明普通用户能否直接调用这次实验中的万级Agent协作系统 [20]
Allegro MicroSystems, Inc. 2027 Q2 - Results - Earnings Call Presentation (NASDAQ:ALGM) 2026-11-02
Seeking Alpha· 2026-11-03 07:14
文章核心观点 - 文档内容为浏览器技术提示信息,要求启用Javascript和cookies以确保正常访问,并提示广告拦截器可能导致访问被阻止,需禁用广告拦截器并刷新页面 [1] 根据相关目录分别进行总结 - 文档未包含任何关于公司、行业、财务数据、新闻事件或投资相关的内容,无法提取行业与公司研究相关的关键要点 [1]
