高通(QCOM)

搜索文档
Qualcomm Stock Gears Up for Earnings After Tech Selloff
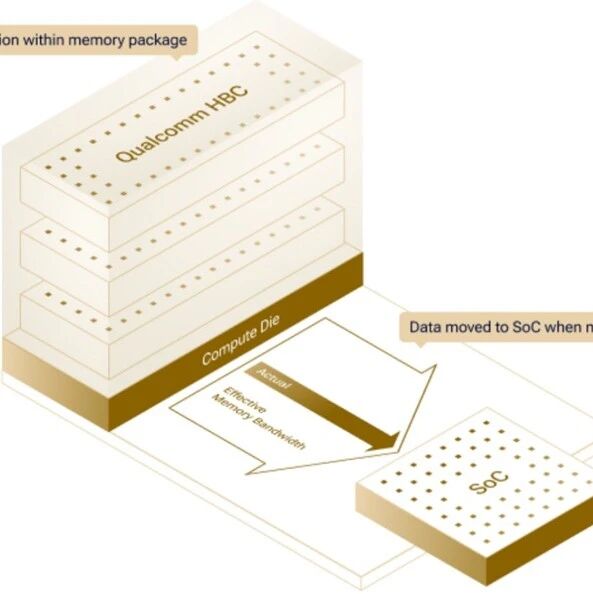
Schaeffers Investment Research· 2026-11-04 04:26
财报预期 - 高通将于11月4日周三美股盘后发布第四季度财报 [1] - Zacks一致预期每股收益为2.16美元,营收为101.5亿美元 [1] - 预期每股收益同比下降28%,营收同比下降9.9% [1] - 高通股价最新报163.50美元,上涨0.9%,在近期科技股抛售后略有回升 [1] - 高通股价年初至今下跌4.5%,160美元水平可能提供支撑 [1] 历史财报后表现 - 高通财报后历史表现总体偏负面,过去12次季报中仅3次次日收高,平均下跌1.6% [3] - 4月财报发布后高通股价曾大涨15.1% [3] - 期权市场目前定价本次财报后波动幅度为8.8%,无论方向 [3] 期权市场情绪 - 财报前期权交易者情绪较往常更为看空 [4] - 在ISE、CBOE和NASDAQ OMX PHLX,高通10日看跌/看涨成交量比率处于年度区间的第81百分位 [4] - 高通股票表现倾向于超出期权交易者的波动率预期,Schaeffer's波动率评分卡(SVS)为82分(满分100),表明当前是买入的好时机 [4]


Qualcomm stock loses crucial support as earnings loom: buy or sell the dip?
Invezz· 2026-11-03 23:45
文章核心观点 - 高通股价本周延续强劲下跌趋势 投资者抛售半导体行业公司 [1] - 高通股价周一跌至162美元 较年初至今高点下跌超过37% [1] 股价表现 - 高通股价周一跌至162美元 [1] - 较年初至今高点跌幅超过37% [1] - 本周延续强劲下跌趋势 [1] 行业动态 - 投资者抛售半导体行业公司 [1]
端侧:国内外新品共振,算力下沉拓宽应用空间
东北证券· 2026-11-03 20:42
行业投资评级 - 报告对计算机行业维持“优于大势”评级,上次评级亦为“优于大势” [4] 核心观点 - 国内外厂商加码AI硬件,新品与政策共同催化端侧需求,海外头部厂商正从模型、系统、应用与硬件等层面探索新的交互入口 [1] - 端侧AI核心价值在于让感知、交互与执行更及时地融入日常使用,产业机会将沿终端芯片与传感器、模型适配与系统调度、应用服务等环节展开 [2] - 消费端存储涨价二阶导趋缓,成本因素对终端配置、定价与盈利预期的新增扰动有望边际减弱,市场关注点有望逐步转向AI功能改善带来的产品溢价与需求增量 [3] 海外端侧AI动态 - Meta于2026年9月宣布计划将个人AI智能体Muse接入AI眼镜,并展示支持实时语音交互的随身设备Muse Charm,同时推进Ray-Ban Meta产品迭代及开发者生态建设 [1] - 谷歌携手三星、Warby Parker和Gentle Monster推进搭载Gemini的智能眼镜 [1] - OpenAI与Jony Ive的新一代AI设备研发推进中,海外头部厂商正从模型、系统、应用与硬件等层面探索新的交互入口 [1] 国内端侧AI动态与政策 - 字节新机“双十二”发布的市场预期叠加北京智能眼镜消费政策,形成产品与政策催化 [1] - 北京对符合条件的智能眼镜按优惠后最终销售价格的15%给予补贴,每件最高500元,有助于降低消费者尝鲜门槛 [1] 端侧AI应用场景 - 端侧AI主要覆盖手机与PC、智能眼镜与耳机等可穿戴设备,AI桌面摆件、机器宠物狗等陪伴型终端,以及智能家居、机器人等领域延伸 [1] - 手机与PC可依托既有生态承接个人助手、办公与内容处理需求 [1] - 可穿戴设备有望通过随身感知、免手持交互拓展使用场景 [1] - AI桌面摆件、机器宠物狗等陪伴型终端可通过拟人化交互与个性化反馈,满足情感陪伴和日常互动需求 [1] - 后续重点关注新品发布、实际体验及销售转化 [1] 算力下沉的技术逻辑与部署条件 - 语音对话、视觉感知与设备控制对响应速度要求较高,个人信息处理涉及隐私,仅依赖云端推理容易受到通信时延、网络条件及持续调用成本的约束 [2] - 将适合的任务放在本地处理,可减少数据上传与网络往返,在部分场景下降低云端调用需求,并通过端云协同承接复杂任务 [2] - 高通持续强化移动平台的本地AI处理能力 [2] - 谷歌Gemma 3n通过架构优化,使部分版本可在约2GB、3GB内存占用下运行,为手机等设备部署多模态模型提供支持 [2] - 实际落地仍需兼顾功耗、续航与使用体验 [2] 存储成本趋势 - TrendForce预计常规DRAM合约价环比涨幅由2026年三季度的13%—18%收窄至四季度的10%—15% [3] - 移动DRAM在此前大幅涨价后,四季度涨幅预计放缓 [3] - 部分消费端存储涨价斜率趋缓,其对终端配置、定价与盈利预期的新增扰动有望边际减弱 [3] 相关公司(未覆盖不作为投资推荐) - 端侧算力与低功耗交互芯片:瑞芯微、恒玄科技(未覆盖)、乐鑫科技(未覆盖)、晶晨股份、全志科技(未覆盖)、星宸科技(未覆盖)等 [3] - 智能终端设计制造:龙旗科技、歌尔股份(未覆盖)、立讯精密(未覆盖)等 [3] - AI陪伴产品:实丰文化(未覆盖)、奥飞娱乐(未覆盖)等 [3] 行业数据 - 成分股数量334只,总市值36204亿元,流通市值32412亿元 [6] - 市盈率132.10倍,市净率3.45倍 [6] - 成分股总营收13355亿元,总净利润277亿元,资产负债率45.46% [6] 历史收益率表现 - 计算机行业绝对收益1M为-6%、3M为-11%、12M为-29% [5] - 相对收益1M为2%、3M为1%、12M为-15% [5]


Why Arm Holdings Stock Lost 29% Last Month
The Motley Fool· 2026-11-03 12:18
文章核心观点 - Arm Holdings在半导体股票表现疲软的一个月中成为该板块的输家之一,尽管没有重大公司特定新闻,但公司对CPU需求的未来预期高度敏感,原因是其即将推出首款芯片Arm AGI CPU [1] - 随着市场情绪转向不利于AI基础设施板块,投资者似乎正在下调对Arm新芯片业务潜力以及传统IP业务增长的预期 [1] - 根据S&P Global Market Intelligence数据,Arm股价上月下跌21%,全月持续走低,反映出更广泛芯片板块的担忧情绪 [2] - Arm股价重新跌破200美元 [4] 公司特定事件:与高通的诉讼裁决 - Arm上月唯一重大公司特定新闻是与高通法律纠纷的裁决,Arm指控高通违反许可协议 [4] - Arm表示陪审团仅判给高通1美元损害赔偿,股价在10月13日当天从5%的抛售中反弹收涨 [4] 宏观与行业因素:利率与AI基础设施情绪 - 月初利率持续上升,10年期美国国债收益率达到5.3%的峰值 [5] - CoreWeave债券收益率图表上的一则帖子引发neocloud股票和更广泛AI基础设施板块的恐慌,投资者担心更高利率将冻结需求并最终导致CoreWeave等公司破产 [5] - CoreWeave当月下跌37%,其走势与Arm平行,虽然Arm与CoreWeave没有直接敞口,但Arm依赖AI芯片的长期需求,尤其是基于Arm架构CPU和新款Arm AGI CPU的芯片,CoreWeave周边的负面情绪蔓延至Arm [6] - Meta Platforms是AGI CPU的指定合作伙伴,其股票在财报发布后大跌,因自由现金流首次转为负值 [6] 未来展望:第三季度财报 - Arm将于周三公布第三季度财报,分析师预期营收增长21.4%至13.8亿美元,调整后每股收益从0.39美元提升至0.48美元 [9] - 投资者将关注有关新CPU的任何评论,该芯片预计本日历季度开始出货,虽然不应期待具体数字,但即使有迹象表明生产按计划进行且芯片已开始出货也将是积极信号 [10]

高通第一代HBC,吊打HBM!
半导体行业观察· 2026-11-03 09:25
文章核心观点 - 高通公司已完成高带宽计算(HBC)内存架构的初步验证,该架构将成为Dragonfly数据中心AI加速器的核心部件,通过将计算芯片置于DRAM堆栈下方实现近内存计算,在能效、带宽和成本之间取得新平衡 [2][3][5] - HBC技术验证结果表明其内存带宽可达LPDDR5X的18倍,能效(每瓦带宽)比HBM4高出5倍以上,虽略低于高通最初期望的6倍目标,但仍代表能效方面的显著提升 [16][17] - 高通正推进HBC商业化进程,首款集成HBC技术的产品Dragonfly AI250计划于明年上半年提供样品,该技术未来也将应用于面向消费者的骁龙产品 [18][23] HBC技术架构与原理 - HBC由高通主导,旨在利用近内存计算在内存容量、内存性能和生产成本之间取得新平衡,公司希望在这三个方面都取得突破 [2] - 与HBM将多个DRAM芯片堆叠在基础芯片上并通过超宽内存总线连接主机处理器不同,HBC通过在堆叠底部放置一个小型计算芯片来省去中间环节 [3] - 将内存置于计算芯片之上最显著的优势在于能效,因为数据传输本身需要消耗能量,长距离传输大量数据则消耗更多能量,通过将内存置于计算芯片之上可最大限度减少数据传输所需能量 [5] - 计算芯片本身并非完整处理器,但通过将内存带宽密集型操作放在该芯片上,然后将结果发送回位于处理器中心的更大计算芯片,高通正努力使内存和计算硬件尽可能靠近彼此 [5] - HBC采用LPDDR5X DRAM芯片而非HBM所使用的超薄高性能芯片,HBC堆栈的容量预计已超过目前HBM4实现方案的容量 [11] - HBC并未完全消除复杂性,与HBM一样仍需使用TSV将多个DRAM芯片键合到另一个芯片上,对复杂制造技术的需求并未消失,只是从内存堆叠和高速芯片连接简化为仅内存堆叠 [10] 成本优势 - HBM采用宽内存总线,需要CoWoS或EMIB等先进封装技术才能将HBM堆栈连接到计算芯片和内存控制器 [7] - 通过将大部分计算工作负载转移到位于内存下方的计算芯片,连接计算芯片和芯片封装上其他位置的大型处理器芯片所需的带宽大大降低,因此可使用更经济的技术如传统的二维有机衬底 [7] 验证过程与测试结果 - 高通在圣地亚哥实验室的测试单元中,将早期HBC样品堆栈连接到初始HBC验证单元上,当时使用的HBC堆栈只有两层DRAM芯片,出货产品将采用四层DRAM芯片,高通目前尚未达到测试全尺寸堆栈的阶段 [13] - 高通使用HBC测试堆栈和自动化测试仪,该测试仪用于测量堆栈作为LPDDR5X设备和HBC设备的性能 [15] - 验证测试得出三大主要结论:技术本身有效证明了可行性;能效(以每瓦带宽计算)是HBM4的五倍以上;测得带宽比外部LPDDR5X高出18倍 [16] - 该技术能效表现略低于高通最初预期,原本希望能效比HBM高出6倍,但若这一水平延续到最终产品中仍代表能效方面的显著提升 [17] - 验证测试也包括产品的散热性能,但公司未透露更多细节,散热问题是需要克服的主要技术难题之一,因为在堆叠式内存架构中作为基础芯片的更活跃计算芯片预计会产生更多热量 [17] - 高通工程师使用行业标准的自动化测试设备(ATE)进行验证工作,测试结果表明HBC的内存带宽可达LPDDR的18倍,能效比HBM4高出5倍(以每秒太比特/瓦计算) [22] 产品路线图与商业化进展 - Dragonfly AI250是今年即将上市的Dragonfly AI200加速器的继任者,将是首款集成HBC技术的产品,目前尚未公布具体上市日期,但据高通透露将于今年上半年开始提供样品,此前曾宣布样品将于今年早些时候推出,此次提前推出可能意味着计划有所提前 [18] - 高通已开始量产其人工智能推理平台AI250,该平台预计将于明年发布,AI250的浮点运算能力(TFLOPS)显著高于HBC,但AI250与LPDDR之间的接口速度比HBC慢 [21] - HBC芯片的验证是多年路线图的第一步,AI250和即将推出的Dragonfly C1000 CPU的样品都计划在明年推出,Dragonfly AI300的样品将于2028年推出 [23] - AI250预计将于2027年上半年开始提供样品 [22] - 如果HBC项目进展顺利,这项技术的应用范围不仅限于蜻蜓人工智能加速器,高通此前已宣布也会将这项技术应用于面向消费者的骁龙产品,但尚未具体说明何时以及会应用到哪些产品上 [18] - 高通正在与多家合作伙伴共同探索HBC技术的各种应用方式,Dragonfly AI250并非唯一一款会采用该技术的产品 [23] - HBC芯片的验证应消除人们对高通能否在明年实现AI250高良率生产承诺的疑虑 [23] 行业背景与市场定位 - 高通高管推出HBC架构旨在解决人工智能推理(以及智能体人工智能)领域长期存在的“内存墙”问题,这些模型的性能越来越依赖于芯片向计算提供数据的速度,而非处理器的计算能力 [19] - 该问题既影响人工智能模型的性能,也影响运行人工智能工作负载的成本,高通概述了两种广泛应用策略:将人工智能模型存储在高速片上内存中,或使用堆叠式高带宽内存(HBM)来支持处理器,高通提倡第三种策略——近内存计算(HBC),将计算机更靠近至关重要的内存 [19] - 高通公司数据中心CPU和AI副总裁兼总经理Gerardo Giaretta表示,传统计算机架构使用DDR内存,内存封装容量通常很大但通道狭窄、数据传输速度非常慢;AI领域主要关注HBM架构,主要增加了通道数量提高了计算单元和HBM之间的数据传输速度,但挑战在于HBM的高昂成本,主要体现在功耗、复杂的中介层、2.5D封装、共主机封装等方面 [20] - Giaretta认为HBC正在解决将数据移至计算端再移回的问题,内存和计算芯片之间自动拥有非常高的带宽,由于数据传输距离不再是毫米级而是微米级,因此可以显著节省能源,数据传输的空间大大减少从而显著降低能耗、提高能源效率 [20] - 在第一代HBC芯片中,高通采用了LPDDR堆栈并在堆栈下方集成了一个完整的AI加速器,大部分AI工作负载的操作都在这里完成,根据架构和具体实现方式的不同部分操作可能会转移到中央系统芯片(SoC)即Dragonfly AI250上进行,但大部分处理工作仍然在HBC封装内完成 [20] - Giaretta表示应把这种特定实现方式下的高性能计算(HPC)看作一个协处理器、一个共存的组件,一旦发出指令且大部分解码操作都在HBC内部完成,端到端性能就不会受到较慢链路的影响,因为只需要发送结果而不需要发送数据 [21] - Giaretta在谈到研究结果时表示,这项技术确实能够实现推理并且显著提升了解决方案的性能,人工智能推理不仅受限于内存带宽而且在很大程度上受限于内存带宽,这项解决方案能够以最低的能耗提供所需的带宽,从运营成本角度来看其能效即数据传输所消耗的能耗至少降低了一个数量级 [22] - 高通一年多来一直在筹划成为人工智能数据中心领域的重要参与者,并力图成为英伟达的替代选择,如今HBC将被集成到Dragonfly AI250中打造完整的AI推理加速器平台,该平台将成为高通Dragonfly Rack(高通用于推理工作负载的全栈基础设施)的基础 [22] - Giaretta表示这项验证对高通尤为重要,因为HBC是解决方案与其他方案的显著区别,高通的解决方案不仅仅是内存,计算能力真正强大且位于内存堆栈之下,不仅仅是提高内存带宽而是将计算能力置于内存之下从而获得更高的内存带宽 [23] - Giaretta强调这并非一款普通的芯片,这是史无前例的,高通通常不会为一款芯片的发布做博客或预告之类的宣传,高通生产过无数芯片但从未这样做过,之所以决定这样做正是因为它是一项全新的技术,而且能够很好地验证明年在高良率制造方面将会取得的成就 [24]