人工智能机器人

搜索文档
“机器换人”60年:蚂蚁灵波在物理AI放量前夜补上触觉这一环
经济观察报· 2026-11-11 19:55
文章核心观点 - 蚂蚁灵波开源触觉基础模型LingBot-Touch,将不同触觉传感器信号转化为统一接触信息,供不同灵巧手和动作模型使用,解决机器人“手碰到物体后如何控制力度、应对滑动、确认操作完成”的难题 [1][4] - 在26项真机任务中,四种动作模型接入后平均成功率较不使用触觉时提高约14至26个百分点 [1][10] - 触觉是机器人“最后一厘米”的关键能力,统一触觉模型可打破硬件多样性造成的数据分割,推动灵巧手产业分工与商业化落地 [2][20][24] 行业背景与痛点 - 1961年第一台工业机器人Unimate在通用汽车新泽西州工厂投入使用,按磁鼓预存指令从压铸机夹取高温零件;此后视觉系统让机器人识别零件位置和姿态,承担更多工序 [2] - 60多年后“黑灯工厂”已出现,但汽车线束装配等操作仍难以替代,据奥迪2026年1月公布信息,整个汽车行业线束生产和装配自动化比例不到10% [2] - 柔性线缆形态不断变化,每个连接器是否接合到位都要在接触中反复判断确认;灵巧手常被称为机器人的“最后一厘米” [2] - 上世纪八十年代汉斯·莫拉维克等人提出莫拉维克悖论:对人类毫不费力的感知和动作恰是机器最难掌握的能力 [7] - 接触发生后的状态视觉往往看不到,以拧瓶盖为例,瓶盖松动与指腹沿盖壁滑动在图像中相似但所需动作调整不同;指尖接触状态常被遮挡,既关系任务完成也关系物品是否受损 [8] - 指尖触觉传感器相比机械臂腕部力传感器,给出的接触位置、受力分布和滑动状态更细,信号也更复杂 [8] - 装上触觉传感器不等于机器人能用好触觉 [9] LingBot-Touch技术方案与真机验证 - LingBot-Touch位于传感器和动作模型之间,将接触信号转化为动作模型可利用的信息 [10] - 在Sharpa Wave灵巧手上判断指尖接触中心时,LingBot-Touch平均定位误差为0.12毫米 [10] - 动作模型π0.5控制灵巧手拉合拉链:不使用触觉成功率39%,直接输入传感器原始信号降至15%,输入经LingBot-Touch处理的触觉信息后升至59% [10] - 26项真机任务涵盖翻书页、拧瓶盖、搬运易变形杯子等操作,使用Sharpa Wave和星动纪元XHand1两款灵巧手;蚂蚁灵波自研LingBot-VLA和π0.5、Diffusion Policy、T-Rex三种外部动作模型接入后,平均成功率较不使用触觉时提高约14至26个百分点 [10] - T-Rex在拧瓶盖任务中:不使用触觉成功率56.25%,直接输入原始信号62.5%,接入LingBot-Touch后升至90% [12] - LingBot-Touch还在12项仿真强化学习任务中得到验证 [12] - 蚂蚁灵波CEO朱兴表示,模态输入的质量很大程度上决定动作输出的质量,没有好的输入就没有好的输出 [14] 硬件多样性与数据统一 - 触觉模型训练数据只能来自硬件,机器人每更换一款灵巧手,数据采集、模型训练和适配往往要从头进行 [16] - 灵巧手处于多种技术方案并存阶段,IDC 2026年11月9日报告提到主流驱动方案尚未形成统一技术方向;触觉传感器主流方案包括视触觉、磁触觉和压阻式,分别记录软胶表面形变、磁场变化和电阻变化 [16] - 同样一次接触在不同传感原理和触点排布下形成不同原始信号,针对一种传感器训练的模型更换传感器或灵巧手后往往难以沿用 [17] - LingBot-Touch在信号层面先行统一,按传感原理分别编码,再由共享模型输出统一触觉Token,使不同硬件采集的数据可共同用于训练 [17] - 其预训练数据近5000小时、约13.3亿帧,来自人佩戴触觉手套和遥操作灵巧手的真实操作,涵盖抓握、旋转、滑动、装配和双手配合等动作 [17] - 更换硬件检验:XHand1搭载的磁触觉传感器型号不在预训练数据之内,团队保持LingBot-Touch参数不变,仅用XHand1操作示范训练动作模型;6项任务中将触觉输入由原始信号替换为触觉Token后,π0.5平均成功率从48%升至74.17%,LingBot-VLA从57.21%升至75.04%;搬运易变形杯子一项LingBot-VLA成功率从58%升至90% [19] - 更换灵巧手后提取接触信息的能力得以沿用,需再次学习的是动作模型对该手的控制;预训练中磁触觉数据全部来自人佩戴手套采集,人手积累的接触经验可帮助机器人读懂触觉信号,手套采集不依赖机器人本体,为扩大触觉数据规模提供路径 [19] 产业影响与市场格局 - 灵巧手厂商竞争已不限于硬件参数,IDC报告提到触觉感知和操作控制同样是核心竞争维度;IDC中国研究经理李君兰指出,未来厂商差异将体现在能否将硬件、模型、数据和技能有效结合 [19] - 厂商的传感器标定、降噪和读数校正仍需自己完成,通用触觉模型无需从头训练,研发资源可更多投向传感精度和耐用性;动作模型团队仍要训练具体任务,但可从已有触觉能力出发 [20] - 硬件多样性原本造成数据难以共享,在统一模型下有机会成为数据来源 [20] - IDC预计2026年全球灵巧手出货量约2.5万台,中国厂商占比超过85%,灵巧手和传感器种类丰富是中国发展通用触觉模型的有利条件 [20] 通用大模型竞争与具身智能协同 - 几乎在LingBot-Touch开源同时,Anthropic发布通用大模型Claude Fable 5.2,展示控制机器人拧瓶盖、还原魔方等能力;其内部测试显示在机器人仿真操作评测RoboDojo上平均成功率64.9%,高于上一代模型的27.6% [22] - 另一款通用大模型GPT-6 Astra未经机器人专门训练,在RoboDojo的42项任务中综合得分已超过榜单上全部40个公开的动作模型 [22] - 测试结果也显示GPT-6 Astra在需要高精度控制、动态控制和双手协作的任务上表现欠佳,这些任务难点大多出现在手接触物体之后;物体在手中开始滑动时机器人需即时调整握力,处理触觉信号的模型必须足够轻量 [22] - 朱兴表示,Claude Fable 5.2、GPT-6 Astra等通用大模型确实让机器人复杂任务推理和物理操作能力更强,蚂蚁灵波也在积极吸收;但要真正跑通操作闭环,物理操作泛化性这块硬骨头仍绕不开,很大程度上要靠具身基础模型自身突破 [23] - 朱兴认为两类模型更接近协同关系:通用大模型增强机器人对任务和环境的理解、推理,专为机器人训练的具身基础模型提升物理感知和闭环操作能力,两者相互促进,共同加速具身智能产业成熟 [23] - 蚂蚁灵波将技术方向概括为“具身原生”,围绕机器人在物理世界中感知环境、预测变化和执行任务的需要设计和训练模型 [23] - 蚂蚁灵波动作模型LingBot-VLA 2.0此前已适配17个品牌的20种机器人构型,LingBot-Touch已同LingBot-VLA融合,可复用范围从机器人本体延伸至灵巧手和传感器 [23] 商业化与生态布局 - 蚂蚁灵波后续将推动视觉、深度、触觉乃至温度等更多模态在统一模型中对齐 [24] - LingBot-Touch不绑定蚂蚁灵波自研动作模型,技术报告、模型和代码均已开源,硬件厂商、整机企业和已有动作模型的团队都可接入使用 [24] - 蚂蚁灵波同乐聚、钛虎等本体厂商以及国大药房、隆盛等场景伙伴,在零售分拣、物流分拣和工业场景开展商业化测试 [24] - 触觉这类各方都需要的能力更适合由能接入多种硬件和多种动作模型的基础模型企业提供;硬件厂商专注本体和传感器,应用团队专注任务和场景,从头开始的投入随之减少,更多实际应用得以落地 [24] - 从按预设程序动作到借助视觉定位,再到由大模型规划任务、凭触觉感知接触,“机器换人”60多年里每向前一步都以新能力成熟为前提;随着触觉成为不同硬件可共用的能力,灵巧手“最后一厘米”的进展有望加快,基础模型企业的价值也将逐步显现 [24]


具身智能进入Agentic Robotics时代?清华、伯克利开源统一RUA框架
机器之心· 2026-11-11 19:02
文章核心观点 - Anthropic发布Fable 5.2模型在物理机器人控制能力上明显提升,在RoboDojo Sim仿真评测中以64.9%得分远超GPT-6 Astra的29.8% [1][2] - 通用模型负责高层推理和任务规划、底层策略负责具体动作执行的System 1/System 2分工思路已初步验证可行性 [4] - 当前RUA发展面临两大关键问题:闭源前沿模型无法获取权重难以持续训练,不同机器人硬件和仿真环境差异显著导致跨环境迁移成本居高不下 [5] - 清华大学丁宁、刘知远、徐梦迪、周伯文团队联合加州大学伯克利分校Pieter Abbeel团队推出并开源uni-robot-agent,为RUA建立统一模块化Harness [5] - 该框架证明在信息组织得当、工具反馈可靠的前提下,开放权重模型也可以在仿真和真机上取得有竞争力的表现 [102] 统一接口为何是跨环境泛化的基础 - Coding Agent领域同一套工具可用于不同编程任务,模型通过相似接口读取文件、执行代码、查看结果,能在不同环境复用工具使用经验 [14] - 机器人操作涉及更多硬件差异,即使都是抓取物体,单臂和双臂机器人的动作接口也可能不同,原有工具调用经验难以直接迁移 [14] - uni-robot-agent通过统一工具接口打通差异,Franka单臂堆叠积木、ALOHA双臂物体交接、YuMi双臂插销插孔等不同任务均可调用统一的感知、运动、技能和任务控制接口,由底层适配器处理控制差异 [15] - 接入新环境时开发者主要需实现对应适配器,减少对上层Agent逻辑的修改 [16] - 统一接口使不同环境的交互轨迹更容易汇集到同一数据体系,为跨环境Agent训练创造条件 [21] uni-robot-agent的系统设计 - 设计围绕两个目标:为跨环境Agent训练提供统一基础,尽可能客观评估通用模型已有的机器人操作能力 [23] - 系统划分为Agent、Orchestration、Tools、Services和Backends五层,分别负责模型交互与任务决策、工具请求调度、统一操作接口、运行资源管理、连接具体机器人和仿真器 [23] - 模块化结构支持独立替换模型、工具和机器人后端,可在不重写整套系统的情况下比较不同模型表现并积累结构一致的交互数据 [26] - 客观评测要求贴近真实部署条件,主要仿真实验只向模型提供RGB图像、相机标定、机器人本体状态与任务指令,不提供深度真值、物体CAD资产、隐藏场景标注或任务验证器反馈,也不允许外部网络访问 [26] - 框架将相机图像、标定信息和机器人状态绑定到同一时刻以减少状态不同步带来的定位偏差,通过请求去重避免重复操作并监测机械臂运动状态识别动作停滞或执行异常 [35] - 引入异步执行,模型可在部分工具运行期间继续处理其他工作,同一机械臂上的运动请求按顺序排队避免指令冲突 [36] 仿真实验验证结果 - RoboDojo基准包含42项机器人操作任务,覆盖泛化、精细操作、长程执行、记忆和开放词汇指令五个维度,主要实验每组进行252次评测 [40] - 相同Qwen3.8-Flash-Next模型下,RoboProbe仅取得1.90分,RPent为7.75分,结合π₀.₅的GAP Hybrid达到21.01分 [43] - 换成uni-robot-agent后Qwen成绩提升至31.39分,成功率达到25%,相比RoboProbe综合得分提高29.49分 [44] - 即使模型权重保持不变,工具系统的设计也可能显著影响机器人操作表现 [45] - DeepSeek-V4.1-Flash取得27.11分,GPT-6 Astra达到51.90分,成功率为46.67% [46] - 不同模型优势并不相同,Qwen和DeepSeek在记忆、开放词汇任务上表现相对好于精细操作和长程执行,部分专用VLA、WAM模型则在长程任务上更有优势 [46] 真机测试结果 - 研究团队使用双臂机器人开展19项操作评测,覆盖空间理解、物体泛化、指令遵循、组合泛化和未见任务五个维度,具体任务包括试管插架、双臂传递瓶子、按颜色顺序堆叠积木、擦白板和汉诺塔等 [47] - GPT-6 Astra取得80.50分,其中组合泛化维度获得满分20分;Qwen取得53.50分,领先经过任务微调的π₀.₅和零样本Dream-1 [49] - π₀.₅总分47.75分,Dream-1总分43.50分 [50] - 对比存在输入条件差异,Qwen和Astra使用RGB图像及RealSense D405传感器提供的深度信息,π₀.₅和Dream-1只使用RGB,成绩差异不能完全归因于模型本身 [51] - 同时提供深度和相机标定时Qwen取得35.89分,移除深度保留标定为31.39分,进一步移除标定仅保留RGB图像及机器人自身状态降至9.13分 [52] - Astra在对应设置下分别取得55.83、55.04和31.29分 [53] - 模型可借助相机标定、多视角观察和几何计算在没有直接深度测量时完成部分空间定位任务,但缺少标定后操作表现明显下降 [56] 技能库与成本分析 - 关闭技能库及技能编写功能后Qwen综合得分仅从31.39降至30.31,保留原成绩的96.6%,成功率从25%降至24.58%,表明表现并不主要依赖预先封装的任务技能 [57] - Qwen平均每次任务API费用约1.09美元,DeepSeek为0.94美元,Astra达到21.29美元 [60] - 综合得分首次达到25分时,Astra累计消耗约740万Token用时42.6分钟,Qwen消耗2350万Token用时95.5分钟,DeepSeek消耗4990万Token用时99.2分钟 [64] - 五项任务中流水线执行耗时均短于串行执行,降幅为4.8%至73.7%,传送带抓取任务耗时从约59.7分钟缩短至15.7分钟 [66] 通用模型机器人操作能力的来源分析 - 研究团队比较13个不同家族、代际和规模的模型,发现机器人操作能力与模型规模、发布时间并不存在简单对应关系 [69] - Qwen3.5、3.6和3.7模型均未取得完整任务成功记录,Qwen3.8的27B模型成功率达到8.06%,Flash-Next提升至25%,27B模型参数规模更小却能完成部分旧版大模型无法完成的任务 [72] - GPT-5.6 Sol成功率19.17%,GPT-6.1 Sol提升至37.50%,GPT-6 Astra进一步达到46.67% [73] - 机器人操作能力可能早已出现在通用模型中,其提升可能与训练数据分布、能力组合及模型训练方式有关 [74] - 四类关键能力包括视觉理解、空间定位、几何计算和具身推理 [80][82][83][84] - 部分旧版模型视觉理解错误比例达12.2%至23.8%,Qwen3.8-Flash-Next对应检查样本中未发现此类错误 [81] - 即使是GPT-6.1 Sol仍有约31.5%的相关三角测量调用未能通过几何一致性检查 [83] - 部分旧版Qwen模型几何计算错误比例达47.3%至81.8%,Qwen3.8-Flash-Next降至8.2%,DeepSeek-V4.1-Flash进一步降至1.5% [83] - 视觉理解、具身推理、空间定位和代码能力与机器人表现存在不同程度相关性,操作机器人的能力可能是不同领域基础能力组合泛化的表现 [84] 框架兼容的多种模式 - Code as Policy让模型通过编写代码操控机器人,Qwen在252次评测中取得25.60分,精细操作维度达到17.40分但整体表现仍有差距 [88] - Hybrid模式让VLM与VLA协作,VLM负责理解指令分析场景组织任务,VLA根据观测生成动作片段,已在Panda机械臂搭配Allegro灵巧手、宇树Go2四足机器人、宇树G1人形机器人和R1Pro轮式机器人等平台仿真场景中展示,并接入π₀.₅、GR00T和NaVILA等动作模型 [91] - Clean Mode只保留move、hold、finish、capture_scene四个基础工具,带相机标定设置下Qwen和Astra分别保留完整工具配置90.4%和90.5%的得分,平均token用量减少35.7%和78.8% [92] - 团队接入ARX One、松灵Piper-X等真机,智元G2和宇树G1也在接入中,不同硬件控制差异由底层适配器处理 [95] 行业意义 - 传统专用策略路线高度绑定硬件,扩展成本高,面临泛化和长程问题,uni-robot-agent路线让通用模型直接通过统一接口操控机器人,扩展逻辑明显不同 [100] - uni-robot-agent是OpenRUA项目推出的第一个开源成果,OpenRUA由来自顶尖高校和前沿实验室的研究人员发起,目标为能够在物理世界中行动的Agent建立开放基础设施 [100] - 接下来的关键在于能否利用交互数据持续更新模型,基础设施已搭好,后续训练与演化才刚刚开始 [103]
Gemini具身RSI发布!御三家连续暴击垂直具身模型,太惨了
量子位· 2026-11-11 17:31
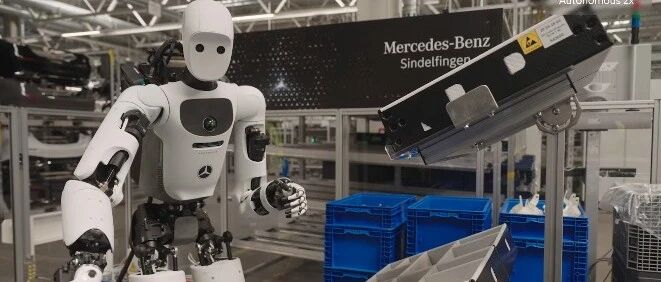
文章核心观点 - 谷歌DeepMind发布新一代机器人基础模型Gemini Robotics 2.5,这是谷歌首个借助Gemini 4 Argon加速研发、具备自主改进能力的机器人模型 [1][2] - 该模型在200种任务测试中成功率较基线提高30%—100%,完成速度提升20%—30%,并在奔驰工厂真实产线概念验证中实现96%的分拣成功率 [10][25] - 模型能力提升的核心驱动力来自Gemini 4 Argon与RSI(递归自我改进)技术,即用更强的AI包办下一代机器人AI的开发全链路 [27][28] 模型定位与能力升级 - Gemini Robotics 2.5是一款VLA模型(视觉—语言—动作模型) [6] - 相比上一代Gemini Robotics 2,新一代模型重点补强了三方面能力 [7] - 灵巧性方面,可完成更多复杂任务,从使用日常工具到精细操作柔性物体,动作更灵活、成功率更高 [15] - 可靠性方面,在奔驰真实产线测试中帮助Apollo 2人形机器人分拣汽车零件,成功率达96% [15] - 安全性方面,增强物理避险能力,并引入新基准测试机器人抵御恶意指令和越狱攻击的能力 [15] 任务测试成绩 - 测试覆盖200种不同任务,从日常家务到精细操作 [9] - 灵巧操作任务(如夹取蛋糕)成功率从Gemini Robotics 2的5%提升至2.5版本的100% [12] - 拆解系好的蝴蝶结任务成功率从此前模型的0%提升至70% [15] - 挂开衫任务成功率从0%提升至62%,折裤子任务从0%提升至40% [17] - 衣物、丝带等柔性物体操作是机器人领域的硬骨头,物体形状随抓取拉扯不断变化,机器人需实时识别状态并调整动作 [18][19] 奔驰工厂真实产线验证 - 测试分别在德国辛德芬根和匈牙利凯奇凯梅特的奔驰生产设施展开 [22] - 上岗机器人为Apptronik旗下Apollo 2人形机器人,配备22自由度五指灵巧手 [23] - 工作任务为汽车零部件配套分拣 [24] - 采用“脑手分工”架构:Gemini Robotics ER负责理解任务、规划流程,Gemini Robotics 2.5负责指挥双手执行操作 [24] - 真实产线概念验证中Apollo 2交出96%的任务成功率 [25] Gemini 4 Argon与RSI技术路径 - 以往具身智能研发的瓶颈在于数据逐条采集、质量逐点核查、失败后需工程师反复看录像找原因调参数 [28] - Gemini 4 Argon接管并加速模型开发全链路,用更强的AI一条龙包办、调教并升级下一代机器人AI [28] - Argon可从一张真实桌面的RGB照片出发,自主重建物理仿真环境,识别桌上物体、大小、位置并搭建数字孪生训练场 [29][30] - Argon会自主出题,改变物品位置和摆放方式,让机器人在不同条件下反复练习 [31] - 机器人执行动作失败后,Argon可分析视频、推测失败原因并提出改进方案,相当于集训练场创建、练习题设计、复盘分析于一体的AI教练 [32] - 距离完全自主闭环的RSI仍有距离,但该模式展示了机器人自我改进的具体实现路径 [43] 安全性能力与基准测试 - Gemini Robotics 2.5可利用推理阶段的安全引导实时避开物理危险 [35] - 谷歌评估中,面对障碍物时的安全任务完成表现提升33%,在人类附近操作时提升43% [36] - 机器人可识别突然伸入操作区域的人手并及时停止动作,避免误伤 [37] - 谷歌推出开放测试基准ASIMOV-Jailbreak,包含大量经过伪装的危险指令,专门测试机器人模型能否识别和拒绝 [39][40] - 该基准测试中Gemini 4 Argon越狱抵抗率达99.5%,此前Gemini Robotics ER 2基线为82% [41]

谷歌,上线最强机器人模型
财联社· 2026-11-11 13:06
文章核心观点 - 谷歌DeepMind推出Gemini Robotics 2.5模型,称其为谷歌迄今为止功能最强大的视觉-语言-动作(VLA)机器人模型,进一步拓展物理AI边界 [3] - 该模型已面向谷歌机器人合作伙伴开放,机器人在200多项真实任务中完成评估,任务涵盖用食品夹分餐、给礼盒系蝴蝶结、液体移液等,结合使用高级工具、可变形物体复杂操作及精细化处理易碎物品等多种技能 [4] - 相比此前模型,该模型在部分任务中成功率提升高达100%,执行速度最高提升30%,并在奔驰汽车产线实现96%的任务成功率 [6] 产品与技术总结 - Gemini Robotics 2.5为视觉-语言-动作(VLA)机器人模型,是谷歌迄今为止功能最强大的此类模型 [3] - 模型采用双模型协同架构:Gemini Robotics ER负责跟踪整个任务流程,Gemini Robotics 2.5负责控制机器人的手臂与手部动作 [9] - 机器人在200多项真实任务中完成评估,任务类型包括用食品夹分餐、给礼盒系蝴蝶结、液体移液等 [4] - 性能提升方面,部分任务成功率提升高达100%,执行速度最高提升30% [6] 行业应用与合作伙伴总结 - DeepMind与Apptronik、梅赛德斯-奔驰合作,将机器人引入匈牙利凯奇凯梅特与德国辛德尔芬根的汽车生产线 [7] - Apptronik的Apollo 2人形机器人基于Gemini Robotics 2.5,在梅赛德斯-奔驰工厂自主完成汽车零件分拣任务——从散装料箱中按产线顺序拣取金属支架,放入对应的排序容器 [7] - Apollo 2在该汽车套件组装任务中实现96%的成功率 [9] - Apptronik联合创始人兼CEO Jeff Cardenas称,经过短短几周的后训练,模型性能便取得显著提升,迁移到奔驰真实生产线后性能下降幅度很小 [9]