世界模型

搜索文档
禾赛发布三维世界数据引擎及全球首款8K超高清AI空间相机:为物理AI打造新基建
IPO早知道· 2026-10-14 22:03
文章核心观点 - 禾赛科技于10月14日正式发布三维世界数据引擎Kosmo,同步推出全球首款8K超高清AI空间相机Kosmo One与AI驱动的云平台Kosmo World,这是公司从激光雷达迈向物理AI核心基础设施的重要一步 [2] - 物理AI缺的不是数据,而是真实世界数据,这已成为行业发展的最大瓶颈,高质量、大规模、低成本长期构成具身智能数据的不可能三角 [3] - Kosmo旨在让高质量、可规模化的真实世界三维数据成为物理AI与内容创作的基础设施 [3] - 公司正布局物理AI两大核心引擎——机器人运动引擎与三维世界数据引擎,Kosmo是三维世界数据引擎的首次系统性产品化落地 [22] - 公司过去十年做的是让机器看见世界,下一个十年要做的是让机器人理解并改变世界,从全球领先的激光雷达公司成长为全球领先的物理AI基础设施公司 [25][20] Kosmo One 产品特性 - Kosmo One单台设备集成超高空间解析力激光雷达、8K超高清影像系统、一英寸大底CMOS与高精度IMU,对空间几何、色彩、纹理和设备位姿进行微秒级同步采集 [5] - 结合3D Gaussian Splatting(3DGS)重建技术与专门的ISP调教系统,Kosmo One可实现毫米级几何精度与最高8K影像级画质,高保真还原材质、纹理、颜色与光影 [5] - 以行业首创的即开即扫、智能指引与一键续扫功能,大幅降低空间采集专业门槛,普通室内场景下约15分钟即可完成100平方米空间扫描 [5] - 配合Kosmo World云平台处理,模型生成速度达行业5倍 [5] Kosmo World 云平台与KSC系统 - Kosmo World是一站式3D内容创作与管理平台,负责将采集数据转化为AI可理解、可交互、可训练的智能空间,底层为禾赛AI原生3D空间重建与理解系统Kosmo Spatial Core(KSC) [7] - KSC一次重建即可同步生成3DGS、mesh、depth三种形态的三维数据 [7] - 原生AIGC能力让空间更完整,未被扫描的区域自动补全,材质与纹理智能识别重建,多视角信息无缝融合,最终生成完整、连贯、可自由漫游的三维场景 [7] - 借助AI驱动的3D语义分割,场景中每一个物体都能被独立识别与定义,从静态三维模型变为具备语义信息与操作属性、可被物理AI理解的空间对象,真实世界由此转化为面向具身智能训练的sim-ready数据 [7] 具身智能领域应用 - 三种形态数据分别击中机器人训练三大痛点:3DGS细腻还原场景外观解决画面假,mesh加速可交互物体的拆分与建模解决交互假,depth提供真实的空间距离信息解决空间不精准 [7] - 三类数据源自同一场景、彼此空间对齐,机器人看到的、抓到的、测到的是同一个世界 [7] - Kosmo生成的数据能针对目标机器人的相机特性做视觉适配,让机器人在自己眼中的世界里训练,进一步缩小仿真与真实的差距,覆盖具身智能训练全流程 [8] - 以Sharpa机器人在DQ冰淇淋门店的应用为例,过去人工建模还原一家门店专业团队需投入约300个小时,Kosmo约15分钟即可完成扫描并生成高度还原的三维训练环境,Sharpa机器人的失败案例降至原来的十分之一,任务成功率提升至99%,最终在真实门店正式上岗 [11] 世界模型领域应用 - 无论图生三维场景还是视频生成,生成的世界越逼真,越需要真实的世界做参照 [13] - Kosmo提供1:1还原、几何精准的真实世界三维数据,连同精确的相机位姿、深度信息与多视角对应关系,成为世界模型理解物理规律的真实坐标 [13] - 基于同一个三维空间,还能自动生成上万条训练轨迹,让高质量真实世界数据的获取效率提升100倍以上 [13] - Kosmo将成为每一家世界模型公司身后的数据底座,让每一次想象都从真实出发 [13] 影视媒体领域应用 - Kosmo已获得全球顶尖影视公司的采用,其中包括皮克斯旗下工业级渲染器RenderMan [15] - 通过将Kosmo生成的高质量3DGS数据接入RenderMan渲染管线,顶尖艺术家首次得以在专业渲染软件中对真实世界数据实现影视级的风格化控制,并能从真实空间中自由提取几乎一切元素作为创作素材 [15] - 近日皮克斯更将这一工作流做成官方教程向全球创作者开源,Kosmo正在成为影视级3DGS的标准定义者 [15] - 在AI影视工业化方向,Kosmo与获得腾讯等头部影视平台认可的跃墨工作室达成合作,以真实空间替代AI生成的虚拟空间,在大幅节省Token消耗的同时提升运镜效果与画面表现力 [16] 文旅文博领域应用 - Kosmo能让历史文化遗产以数字化形式永久留存,把文物与空间从静态档案变为可远程访问、可沉浸体验、可自由再创作的数字素材 [16] - Kosmo已与联合国合作伙伴TRIC展开合作,以成都杜甫草堂为蓝本创作沉浸式数字艺术作品 [16] 空间商业化领域应用 - 禾赛与高德达成战略合作,首批三维重建的重美术馆、偏锋画廊已上线高德扫街榜飞行街景,位置服务由此从二维地图升维至三维空间,导航到一家店开始走向导航到一件商品 [17] - 对商家而言,门店空间成为可持续更新的数字资产,货架陈列怎么摆、商品放哪里第一次有了可分析的数据依据 [17] - 对消费者而言,能在出门前沉浸式体验一家店值不值得去 [17] - 未来更多真实场景将经由Kosmo接入高德这个近10亿月活的国民级应用,让三维世界数据服务每一次出行与消费决策 [17] 开放生态与商业模式 - 数据层面,开放采集图像、点云、IMU及3DGS、mesh等三维资产 [19] - 生态层面,连接英伟达Isaac Sim、Isaac Lab、UE、RenderMan、Houdini等机器人仿真与主流创作平台 [19] - 构成Kosmo的两类商业模式:一是以软硬件一体化产品服务具身智能、影视娱乐、文旅文博等行业客户,二是面向世界模型与物理AI企业提供规模化的高质量真实世界空间数据生产服务 [19] 公司背景与机器人硬件侧布局 - 过去十余年,公司围绕激光雷达建立起从光机电软硬一体设计、自研芯片、超大规模精密制造的全栈能力,成长为全球汽车与机器人产业的重要基础设施提供者 [20] - 禾赛激光雷达交付量已连续9年实现翻倍式增长,在ADAS乘用车与Robotaxi两大市场的市占率均以断层优势稳居全球第一 [20] - 在机器人硬件侧,公司以真实机器人需求反向定义底层硬件——AI-Defined Hardware,由AI的真实需求定义硬件,而不是让AI迁就硬件 [26] - Sharpa灵巧手以22个主动自由度做到与人手1:1同构,已进入英伟达Isaac GR00T人形机器人参考方案,并被伯克利、斯坦福、南洋理工等全球顶尖高校和研究机构采用 [26] - 其首款旗舰触觉灵巧手Wave(W01)——业内首个实现量产的高自由度可反驱灵巧手——正是基于禾赛动力模组打造 [26] - 相比同类产品,禾赛动力模组体积缩小37%、功率密度提升至3倍 [27] - 截至2026年第二季度末,已累计交付超过1万套,产品范围正由灵巧手模组向全身关节模组拓展,预计2027年动力模组出货量将达到六位数水平 [27]


首发丨北大+南洋理工学霸组队,云蝶融资数亿元
投中网· 2026-10-14 12:34
文章核心观点 - 云蝶科技完成数亿元B+轮系列融资,由StellarS Capital、亚洲联合基建(00711.HK)、长浙投资、图灵量子等联合投资,资金主要用于具身智能核心技术迭代与真实场景规模化落地 [4] - 云蝶科技是世界模型创业潮中一个横截面丰富的“例外”,成立于2019年,已有稳定营收和已验证商业场景,却选择切入世界模型赛道 [6] - 公司提出“环境增强的世界模型”与“系统级大脑”作为核心技术方向,强调模型必须在真实任务中获得“感知-动作-结果-接管”闭环数据 [4] - 公司同时推进模型、本体和场景交付,形成闭环,但战略重点围绕真实场景和任务,建立能够持续优化的具身智能系统 [23] 世界模型行业融资热度 - 硅谷方面,Meta前首席科学家杨立昆创办AMI Labs,种子轮融资达10.5亿美元 [3] - 世界模型主要奠基者之一皮特·弗洛伦斯创办Generalist AI,种子轮融资达4亿美元 [3] - 李飞飞创办的World Labs成立仅2年,以82亿美元卖给AMD [3] - 国内方面,截至2026年10月10日,世界模型赛道融资事件达88起,其中亿元级别以上融资事件超过50起 [3] 云蝶科技融资与业务概况 - 云蝶科技宣布完成数亿元B+轮系列融资 [4] - 本轮资金主要用于具身智能核心技术迭代与真实场景规模化落地,重点提升机器人持续工作的可靠性、跨场景部署效率及长期服务能力 [4] - 公司成立于2019年,产品已进入酒店、医疗、体检康养等高价值场景,2025年营收超过数亿元 [6] - 产品名单包括RoboForge系统级具身大脑和WING机器人家族,其中WING Air已实现交付,可通过更换末端工具适配清洁、巡检等任务 [6] - 另外两款产品分别面向复杂服务操作,以及能量补给和数据调度 [6] 公司技术演进路线 - 2019年创业时主要做产业数字化和智能化,依托视觉识别、数据治理、智能系统等技术 [9] - 进入大模型时代后,开始做垂直大模型和行业智能体 [9] - 2025年开始加强世界模型和具身智能研究,提出“具身环境智能”范式,发布RoboForge系统级具身大脑 [9] - 技术演进路线为:过去让现实世界数字化,现在让数字智能进入现实世界 [10] 世界模型需提升的三种能力 - 第一,对现实世界的理解和预测能力,识别当前状态并预测不同动作和策略带来的结果差异 [11] - 第二,训练效率和泛化能力,世界模型可用于生成训练场景,尤其是大量长尾数据,作为真机数据的补充 [12] - 第三,把具体项目中的经验转化成可复用的系统能力,将同类场景中学到的空间认知、任务经验和执行策略迁移到相似场景 [12] “环境增强”的三个阶段 - 第一个阶段是环境约束和环境标准化,选择连锁酒店、标准化物业等具有重复性和标准化基础的场景,按照真实场景1∶1复刻训练场 [16] - 在真实部署中采用Human-in-the-loop人机协同方式,明确哪些行为、流程由人完成,哪些由机器人完成 [17] - 第二个阶段是让环境成为数据的一部分,包括本体视角数据、第三方视角数据(“上帝视角”)和系统属性数据,共同构成智能空间的数据底座 [17][18] - 第三个阶段是让环境变得更聪明,即“环境智能体化”,通过异构多智能体协作完成复杂任务,如台账智能体、调度智能体、配送机器人等协同 [18] - 通过环境增强,让环境适配不同智能水平的机器人,甚至参与决策,目标提高机器人在真实场景中持续、规模化部署的能力 [18] 公司发展节奏与2025年转折 - 2025年之前核心任务是找到真实场景的市场需求,建立产品、客户和交付体系,让公司具备独立发展和自我造血的能力 [20] - 2025年前后看到AI出现新机会:大模型和智能体技术不断发展,AI从理解信息走向执行任务;具身智能成为连接数字世界和物理世界的重要方向 [21] - 2025年开始系统投入具身智能研发,与高校共建联合实验室,布局世界模型、多智能体协同和强化学习 [21] - 2025年与北京大学开展具身智能联合研究,今年发布“1+2+N”真实世界具身智能联合研究计划 [21] 本体制造战略 - 2025年已有小批量非人形机器人业务,如轮式巡检机器人;今年开始更大规模做轮式双臂机器人 [23] - 公司涉及模型、系统级平台和具身本体,形成闭环,但不会把核心零部件、整机、模型全部自己做 [23] - 战略重点围绕真实场景和任务,建立能够持续优化的具身智能系统;模型能力和系统级大脑是最核心能力 [23] - 本体定义为“任务型本体”,要求符合实际岗位需求,把模型和系统能力转化成可靠、经济的物理行动 [23] - 设计本体时倾向与产业链优秀企业合作,关键模块如通信底座和能源底座自主或联合研发,关节模组、谐波减速器等成熟部件与产业链企业合作 [24] - 先根据场景和岗位抽象出“任务簇”,再从任务簇中提炼基本能力,用这些能力定义本体参数 [25] 数据壁垒与竞争壁垒 - 行业里大量数采公司、数据公司强调数据优势,但需要区分“拥有数据”和“拥有持续产生高价值数据的能力” [29] - 高价值数据来自真实任务,如自动驾驶中大量车辆在真实道路上的持续运行,系统错误判断后驾驶员纠正产生反馈数据 [29] - 仿真和实验室数据有价值,但机器人需要真实道路上的验证和反馈,预先设计的标准动作很难覆盖真实运营中的突发情况 [30] - 云蝶关注机器人在真实环境里执行任务为什么成功、为什么失败,人工如何接管,人机如何协同,系统如何恢复 [31] - 竞争壁垒包括:理解行业的实际经验和业务规则;跑通标准任务后推广到大量相似单元;把真实场景变成持续产生系统能力提升所需数据的底座 [32] - 壁垒在于能否持续以更低成本、更高质量产生真实业务数据,并把数据转化成技术和产品优势 [32] 团队模式与融资用途 - 团队采用“双峰或多峰模式”:一端是行业老兵,积累大量B端场景资源,理解行业经验,能定义需求、定义问题并保证交付 [34] - 另一端是技术团队,背景复合,涉及空间感知和预测、VLA(视觉—语言—动作)模型、异构多智能体协作等多个技术栈 [34] - 本轮融资资金主要投向三个方面:把机器人投入更多场景积累更多数据;模型训练,包括算力投入;加强技术研发团队建设 [35] - 及格线是把现有系统级能力在某些场景、特定任务流中成功部署,让机器人在真实业务流程中持续作业、持续自我诊断、持续进化 [35] - 满分线是把这套模式复制到大量标准化作业单元中,如在成百上千家酒店中持续作业,承担复杂任务、复杂空间认知与感知、动作规划的工作 [36] - 达到满分线状态将持续产生大量数据,跑通规模化、持续运转的数据飞轮 [36]
给Ego数据补上「全身」,世界模型的Scaling有了新的路径
机器之心· 2026-10-14 10:54
机器之心发布 机器人数据采集过去几年,一直在努力做一件事: 摆脱机 器 人本体,让采集变得更轻、更便宜,也更容易扩大规模。 最早,机器人主要依靠遥操作学习。操作员控制机器人完成任务,系统记录关节状态、末端动作和环境信息。这种方式得到的数据可以直接用于机器人策略训 练,但代价也很明显:每一小时数据背后,都需要真实的机器人、操作设备和相应的人员投入。 后来,UMI 等便携式示教方案开始摆脱本体约束,Ego 第一视角采集则将这件事进一步简化。人戴上相机,就可以走进家庭、办公室、商店,在真实环境中完成 各种操作。 数据采集终于不必总是围着机器人转了。 比如铺床。人需要走到床边、抓住被角、抬起双臂将被子展开,再沿着床边移动,一点点拉平褶皱。身体的位置决定双手能够触及哪里,抓握位置和力度则影响 布料如何展开。 一段第一视角视频可以记录眼前发生的操作,但视野之外的躯干、腿部如何运动,双手与布料接触时的压力如何变化,却无法直接测量。对于要学习全身移动灵 巧操作的机器人来说,这些恰恰是重要的训练信息。 这就把机器人数据采集推向了一个新的选择:继续用更轻的设备获取更多视频,还是重新补回那些在轻量化过程中被舍弃的交互信息? 破晓智 ...
国内最年轻AI教授创业:要让世界模型走向全身全模态
量子位· 2026-10-14 10:34
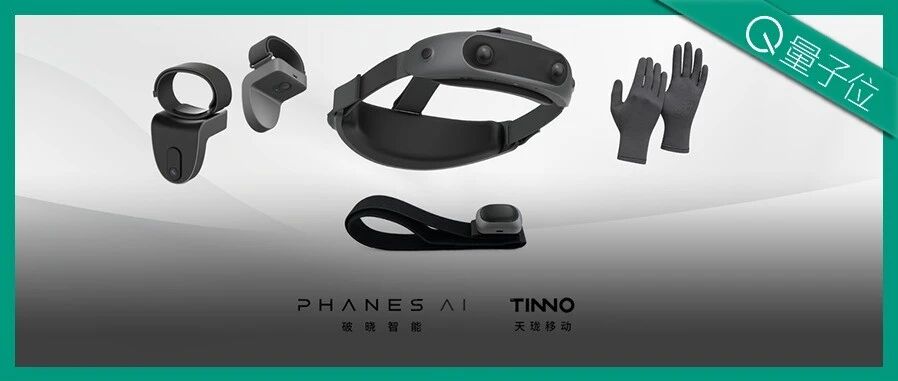
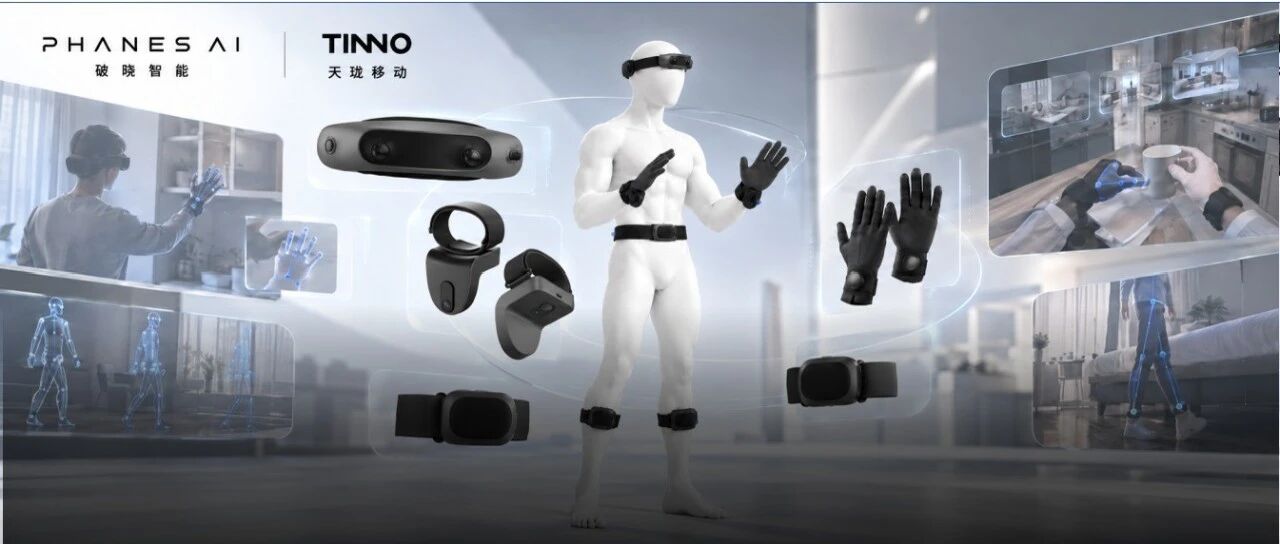
文章核心观点 - 机器人数据采集正从单纯扩大人类操作数据规模转向关注数据中身体运动与触觉交互信息的完整性[1][2] - 破晓智能联合天珑移动发布全身全模态数据采集系统SeePhys Hub,在轻量化Ego路线基础上补回全身运动与触觉信息[5][6] - 公司最终目标是做好全模态世界模型,但当前选择从数据采集设备入手,解决模型所需数据难以低成本规模化获取的问题[27][28] - 行业数据采集趋势从遥操作走向Ego做减法,但当机器人学习迈步弯腰搬运和精细操作时,镜头外的身体运动与接触信息成为不可舍弃的部分[32][33] 产品与技术方案 - SeePhys Hub由四目头环两个腕部手环三个腰腿部动作追踪器和一副触觉手套组成,通过视觉与运动信号融合恢复全身姿态[5] - 采用稀疏节点方案,在腰部和双小腿布置三个动作追踪器,结合头部视觉与双腕信息,通过算法恢复全身姿态[11] - IMU提供运动相关信号,UWB提供节点间测距信息,再与视觉结合估计全身姿态[11] - 四目头环提供360°环视,腕部相机补充近距离操作细节,可选配触觉手套记录双手与物体接触时的压力变化[11] - 头环内相机IMU和UWB的同步精度不超过0.5毫秒[15] - 头环重量不超过220克,单个腕部手环不超过75克[17] - 配套平台负责解析清洗动作切分和语义标注,并衔接场景重建姿态估计和手部追踪,动作重定向将人的动作映射到机器人本体[15] 工程取舍与产品定位 - 触觉手套采用可选设计,手环与手套可以分开使用,客户按任务选择配置[22][24] - 数据采集运营方第一个要求是不要让人戴手套,因为洗碗等防水场景中精细操作会受穿戴影响,传感器本身也可能出现噪声[23] - 团队曾在测试中遇到手套抓过几次水杯后空手伸开仍显示局部压力的情况[23] - 在破晓创始人兼CEO杨朔描述的三层数据金字塔里,底层是量大的互联网视频,顶层是高精度动捕真机操作等数据,SeePhys Hub瞄准中间层[18] - 动捕数据可用于监督姿态估计,真机数据帮助模型适配机器人,人类视频提供更多场景和操作,可穿戴设备补充走进真实环境跟着人持续记录的能力[21] 商业模式与合作 - 破晓侧重产品设计与算法,天珑移动提供成本控制供应链及质量保障方面的经验[24] - 有算法能力的客户可以购买硬件自行处理数据,需要完整方案的客户可以选择配套算法和本地部署,科研等场景还可以使用云端平台获得处理后的数据[24] - 数据采集运营商具身模型团队场景方和科研机构等,都是团队瞄准的使用者[25] - 设备背后的积累还包括姿态估计算法以及用于训练和验证算法的配对数据[25] 团队背景与研究积累 - 破晓智能创始人杨朔1998年出生,现任哈尔滨工业大学(深圳)计算机科学与技术学院长聘教授博士生导师,26岁获评,是国内人工智能领域最年轻的教授博导[29] - 公司90%以上的核心成员毕业于清华大学北京大学香港大学哈尔滨工业大学等高校,研究与工程实践覆盖全模态大模型世界模型大规模数据处理及硬件研发[29] - 2026年5月EgoTouch数据集及TouchAnything研究公开,前者将第一视角视频双手姿态与真实触觉压力同步记录,后者尝试从视频中估计接触区域和压力分布[30] - TouchWorld模型提前预测视觉与接触目标,执行中再根据真实触觉反馈修正偏差,插插头擦锅抽纸都是团队用来测试它的真机任务[30] - SeePhys Hub将研究范围从双手接触扩展到全身运动[30] 战略规划与行业判断 - 团队预计在2027年推出全模态世界模型,并优先在工业餐饮零售等垂直场景开展应用验证[30] - 破晓现阶段仍不准备造自己的机器人本体,杨朔认为数据模型和落地场景还在变化,过早定下硬件可能限制后续算法方向,称为纯纯的沉没成本[31] - 当前团队利用通用本体测试模型,并计划与本体商场景方合作开展应用试点,未来是否推出自己的本体要等场景需求和商业回报更明确[32] - 破晓对模型竞争的判断是,机器人最终需要在真实环境中实时感知决策和执行,许多场景还要求端侧部署,如何让有限规模的模型掌握物理交互能力并稳定完成任务可能是更加现实的挑战[32] - 行业数据采集一直在做减法,从遥操作走向Ego,摆脱机器人本体简化采集设备,让更多人类日常操作成为可以规模化获取的训练数据[32] - 破晓选择在轻量化路线之上补回全身运动与触觉,SeePhys Hub负责记录更完整的人类真实交互,未来的全模态世界模型则要进一步学习动作接触与物理结果之间的关系[33]